资源简介
蜘蛛池的应用方法在搜索引擎优化领域长期处于灰色与白色交界的特殊位置。其核心逻辑并非直接提升目标站点的权重,而是通过构建一个受控的站点网络,引导搜索引擎爬虫(尤其是百度蜘蛛、Googlebot、Bingbot)按照预设路径访问目标页面,从而加速收录、提升抓取频次,并在特定场景下影响页面在索引库中的新鲜度。本文从工程实现角度拆解蜘蛛池的应用方法,不讨论违规内容生成,仅聚焦于爬虫调度与资源分配的技术框架。
一、蜘蛛池的基础架构与爬虫识别
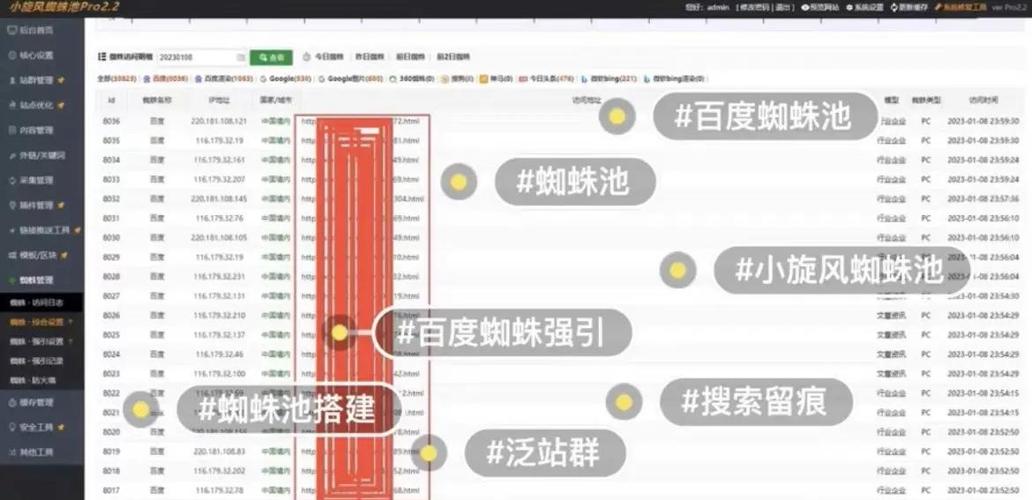
一个可运行的蜘蛛池通常由三部分构成:域名池、内容注入层、日志与调度中心。域名池需要大量已备案或未备案但可解析的域名,这些域名最好有历史解析记录,且未被搜索引擎彻底拉黑。内容注入层负责在域名上生成可被爬虫解析的HTML页面,页面内包含指向目标站点的链接。调度中心则通过分析服务器日志中的User-Agent、IP反向解析、访问频率等特征,区分真实用户与搜索引擎爬虫。
识别蜘蛛的常用方法包括:检查User-Agent中是否包含“Baiduspider”“Googlebot”“bingbot”等标识;对访问IP进行反向DNS查询,确认其属于搜索引擎官方网段;观察访问行为,蜘蛛通常不会加载CSS、JS中的非必要资源,且请求间隔具有规律性。只有准确识别蜘蛛,才能触发后续的链接推送逻辑。
二、蜘蛛池的应用方法之链接调度策略
蜘蛛池的应用方法中,最关键的环节是链接调度。常见策略有三种:轮询式、权重优先式、随机扰动式。轮询式将目标链接均匀分配给池内每个域名,适合新站快速提交。权重优先式根据域名历史抓取频次和收录率分配链接,高权重域名获得更多展示机会。随机扰动式则在链接周围加入大量无关但合法的文本与内链,避免被搜索引擎判定为链接农场。
实际操作中,建议采用混合策略:每日定时从目标站点提取最新URL,生成短链接或伪静态路径,然后按域名权重比例写入各站点的页面模板。每个页面中,目标链接不应超过3个,且需与页面主题有一定语义关联。例如,目标页面是关于“不锈钢法兰”的,那么蜘蛛池页面中应出现“管道配件”“工业标准”等上下文词汇,而非直接堆砌关键词。
三、内容生成与反识别处理
纯静态的链接列表极易被识别为作弊。蜘蛛池的应用方法要求内容层具备一定的自然语言特征。可以使用模板拼接、同义词替换、段落随机排序等方式生成差异化文本。每个域名下的页面结构应略有不同,例如有的使用H1标签包裹标题,有的使用H2;有的页面包含分页,有的则没有。
此外,需要控制页面中的出站链接比例。一个页面如果只有出站链接而没有入站链接或站内链接,会被视为低质量节点。建议在每个蜘蛛池站点内部建立简单的树状结构:首页链接到栏目页,栏目页链接到内容页,内容页中再放置目标链接。这样蜘蛛在爬取过程中会自然沿着路径前进,而不是直接跳转到外部。
四、日志分析与反馈调优
蜘蛛池的应用方法不是一次性搭建,而是持续调优的过程。每天需要分析服务器日志,统计每个域名的蜘蛛访问次数、抓取深度、返回状态码。对于连续多日无蜘蛛访问的域名,应将其从活跃池中移出,替换为新域名。对于抓取频次高但目标页面未被收录的域名,需要检查目标链接是否被nofollow、是否被robots.txt屏蔽、是否返回了302跳转。
一个实用的调优指标是“蜘蛛转化率”:蜘蛛访问目标链接的次数除以蜘蛛访问蜘蛛池页面的总次数。如果该比率低于5%,说明链接调度过于隐蔽或页面质量太差;如果高于30%,则可能触发搜索引擎的异常检测。理想区间为8%至15%。
五、风险控制与合规边界
必须指出,蜘蛛池的应用方法若用于批量制造垃圾链接、劫持搜索流量或传播恶意内容,将违反搜索引擎质量指南,导致目标站点被降权甚至删除。合规的用法仅限于:加速自身多个合法站点的收录、测试搜索引擎对特定页面结构的抓取反应、以及在新站上线初期引导蜘蛛发现入口。任何将蜘蛛池作为排名操纵工具的行为,都不具备长期稳定性。
技术层面,建议为蜘蛛池设置独立的IP段和服务器,避免与目标站点共用同一C段。同时,定期清理池内被搜索引擎标记为“危险”的域名,防止连带惩罚。最后,所有蜘蛛池页面应设置合理的robots.txt,允许蜘蛛抓取但禁止索引池内页面本身,仅将权重传递至目标链接。
总结而言,蜘蛛池的应用方法是一套围绕爬虫行为设计的工程化流程,其有效性取决于域名质量、内容差异化程度、调度策略与日志反馈的闭环。脱离这些细节,单纯堆砌域名和链接,只会得到无效的抓取和潜在的风险。
亮点功能
- ✦ 蜘蛛矿池重磅发布全新升级方案,引领矿业高效新时代
- ✦ 蜘蛛矿池重磅发布全新升级方案,引领矿业高效新时代
- ✦ 蜘蛛矿池重磅发布全新升级方案,引领矿业高效新时代