资源简介
搜索引擎蜘蛛的抓取行为遵循特定规律,理解这些规律是选择蜘蛛池程序的前提。蜘蛛池的本质并非单一程序,而是一套由域名管理、内容生成、链接调度、日志监控组成的协同系统。建蜘蛛池用什么程序,取决于你希望实现的抓取频率、内容承载方式以及服务器资源规模。
第一类常用程序是泛域名解析配合Nginx或OpenResty。Nginx本身不生成内容,但通过rewrite规则和fastcgi_pass将不同子域名请求分发到后端处理脚本。OpenResty在Nginx基础上集成Lua,可以在边缘节点直接完成UA识别、蜘蛛IP校验、内容拼装和跳转逻辑。这种方案的优势在于并发高、内存占用低,适合域名数量在几千到几万级别的蜘蛛池。配置时需要编写lua脚本判断User-Agent中是否包含Baiduspider、Googlebot、Sogou spider等标识,对真实蜘蛛返回静态化内容,对普通用户返回正常页面或302跳转。
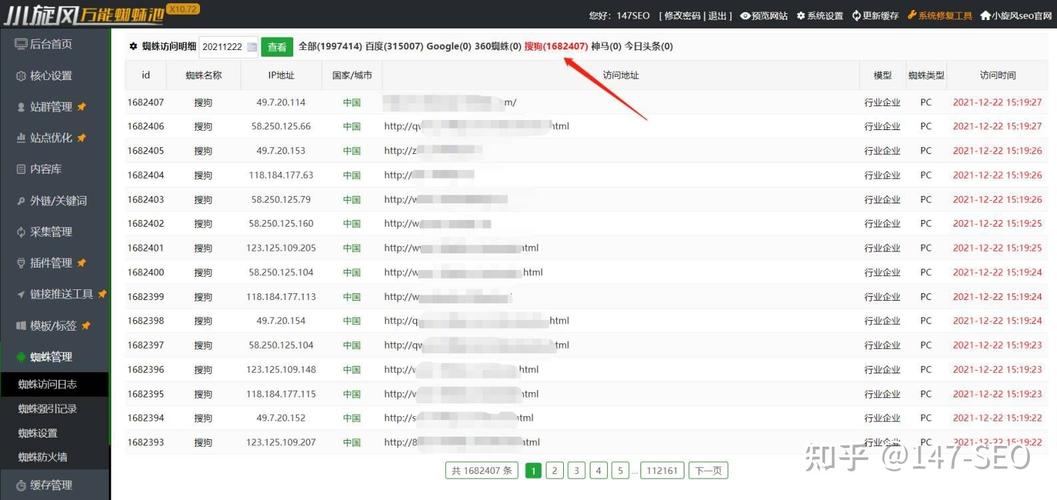
第二类程序是Python生态中的Scrapy配合Redis做分布式调度。Scrapy负责抓取上游内容源,Redis负责去重和队列管理,再通过Flask或FastAPI搭建一个轻量级内容输出接口。蜘蛛池的前端域名统一解析到这台API服务器,由API根据请求域名和路径从Redis或数据库中取出对应内容返回。这种方案灵活度高,可以动态控制每个域名下的文章数量、更新频率和内部链接结构。缺点是Python进程在高并发下需要配合Gunicorn和Gevent,否则容易成为瓶颈。
第三类程序是PHP结合MySQL或SQLite。很多传统的蜘蛛池程序采用PHP编写,因为虚拟主机和宝塔面板部署成本低。典型逻辑是:index.php接收请求,根据HTTP_HOST查询域名表,再根据REQUEST_URI查询内容表,最后用模板引擎渲染输出。为了提高蜘蛛抓取效率,通常会在PHP层加一层文件缓存,把每个URL的最终HTML写入静态文件,Nginx直接返回静态文件而不经过PHP。这种程序适合中小规模,域名数量在几百到两千之间,服务器配置为4核8G即可稳定运行。
第四类程序是Go语言编写的专用蜘蛛池系统。Go的协程模型天然适合处理大量并发连接,单机可以轻松支撑数万QPS。常见做法是用Go写一个HTTP服务,内置域名路由、内容池、蜘蛛IP库和访问日志。内容池可以对接外部API或本地文件,蜘蛛IP库定期从官方渠道更新。Go程序编译后只有一个二进制文件,部署简单,资源占用低。对于需要快速收录大量页面的场景,Go蜘蛛池配合CDN回源是效率较高的组合。
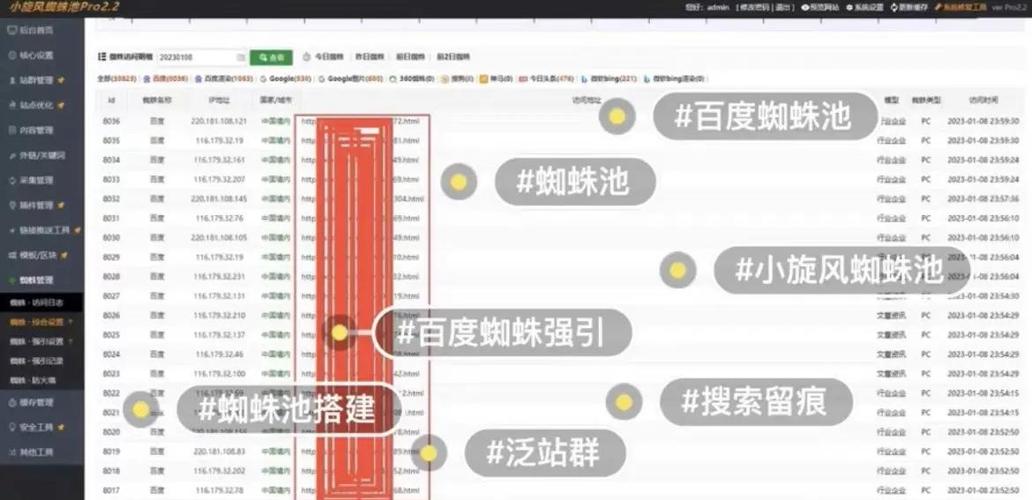
无论选择哪种程序,建蜘蛛池用什么程序的核心判断标准有四点。第一,能否准确识别蜘蛛IP而非仅依赖User-Agent,避免被伪造蜘蛛消耗资源。第二,能否为每个域名生成差异化的标题、描述和正文,避免站群内容完全重复。第三,能否记录每个URL的抓取时间、返回状态码和蜘蛛类型,便于分析抓取频次。第四,能否方便地增减域名和调整链接结构,而不需要重启服务。
在实际部署中,建议将蜘蛛池程序与内容源分离。内容源可以是人工撰写的文章库、API采集的行业资讯或经过伪原创处理的文本。蜘蛛池程序只负责调度和输出,不负责内容生产。这样当搜索引擎算法更新时,只需要调整内容策略,而不必重写整个蜘蛛池系统。另外,服务器地理位置和IP纯净度对抓取也有影响,同一C段IP下域名过多会触发风控,建议分散到不同C段或使用多台低配服务器。
最后需要明确,蜘蛛池程序本身不保证收录。它解决的是让蜘蛛更快发现URL的问题,而是否收录取决于内容质量、网站结构和用户体验。如果内容空洞或大量采集,即使蜘蛛每天抓取十万次,索引量也不会增长。因此,建蜘蛛池用什么程序只是技术环节,内容策略和域名历史才是长期有效的关键。
亮点功能
- ✦ 不错的蜘蛛池程序实测:秒收百万页面,搜索引擎蜘蛛狂飙
- ✦ 不错的蜘蛛池程序实测:秒收百万页面,搜索引擎蜘蛛狂飙
- ✦ 不错的蜘蛛池程序实测:秒收百万页面,搜索引擎蜘蛛狂飙