资源简介
超级蜘蛛池的运行原理,本质上是对搜索引擎爬虫抓取行为的一种逆向工程与资源调度。它并非单一技术,而是一套融合了DNS解析、反向代理、内容动态生成与链接权重传递的复合系统。理解其运作机制,需要从蜘蛛的抓取逻辑、池子的结构设计以及流量引导策略三个层面切入。
一、蜘蛛抓取的行为特征与可利用缺口
搜索引擎蜘蛛(如Baiduspider、Googlebot)在抓取网页时,遵循一套基于优先级队列的调度算法。其核心判断依据包括:域名历史权重、页面更新频率、外链质量、服务器响应速度以及内容原创度。蜘蛛池的构建者发现,当大量低权重域名被同一套IP或C段服务器托管时,蜘蛛会因“站点相似性”而降低抓取频次。但若将这些域名分散到不同C段、不同地理位置的IP上,并模拟独立站点的更新行为,蜘蛛便会将其视为多个独立信源,从而增加整体抓取配额。
另一个关键缺口是蜘蛛的“抓取预算”机制。每个域名在单位时间内被分配的抓取请求数有限。蜘蛛池通过泛域名解析与动态子域生成,将主域拆分为无数个三级、四级子域,每个子域都拥有独立的抓取预算。当蜘蛛访问主域时,会被自动跳转或链接至这些子域,从而在短时间内消耗掉大量抓取配额,并将这些配额集中导向目标页面。
二、池子的物理架构:IP池、域名池与内容池
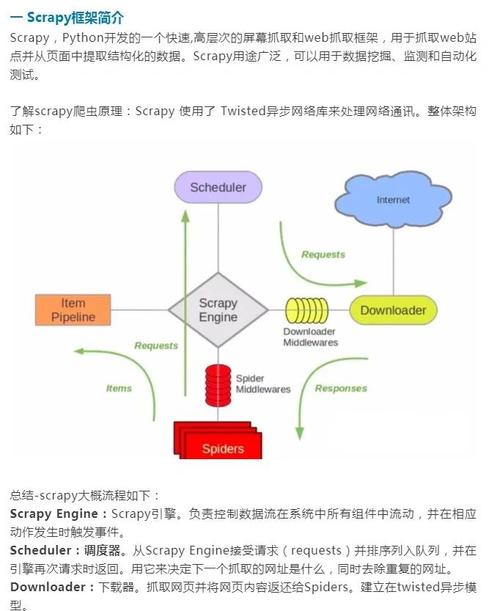
超级蜘蛛池的硬件基础是IP池。通常采用多C段、多机房、多运营商的服务器集群,每个IP绑定少量域名,避免被识别为站群。IP池通过反向代理技术,将蜘蛛的请求动态分配到不同的后端服务器。后端服务器上运行着内容生成系统,该系统会实时抓取互联网上的公开内容,经过同义词替换、段落重组、标题改写后,生成大量“伪原创”页面。这些页面并非为了用户阅读,而是为了满足蜘蛛对“内容新鲜度”的偏好。
域名池则负责承载这些页面。域名通常来自过期老域名、抢注域名或批量注册的低价域名。老域名自带历史外链和权重,能更快吸引蜘蛛。域名池与IP池之间通过DNS轮询和智能解析绑定,使得同一域名在不同时间可能解析到不同IP,进一步干扰蜘蛛的站点识别逻辑。
内容池是蜘蛛池的“燃料”。它包含关键词库、文章模板、链接锚文本库。当蜘蛛访问某个池内页面时,系统会根据预设的关键词,从内容池中抽取相关段落,动态生成一个包含目标链接的页面。这个页面可能只有少量文字,但链接指向明确,且周围环绕着大量相关关键词,从而在蜘蛛眼中形成“高相关度”的链接推荐。
三、链接权重传递与蜘蛛路径锁定
蜘蛛池的核心目标不是让蜘蛛抓取池内页面,而是让蜘蛛沿着池内预设的链接路径,最终爬向目标站点。这一过程依赖两个机制:链接闭环与路径锁定。
链接闭环是指池内页面之间互相链接,形成一张密集的网。蜘蛛进入任何一个页面,都会发现数十个指向其他池内页面的链接。这些链接的锚文本经过精心设计,包含目标关键词。蜘蛛在爬行过程中,会不断沿着这些链接前进,逐渐深入池子内部。由于池内页面数量庞大,蜘蛛的抓取队列会被迅速填满,从而减少对外部低权重站点的抓取,变相提高了目标站点的抓取概率。
路径锁定则是在池子中设置“终点页面”。这些页面只包含一个或少数几个指向目标站点的链接,且链接周围没有其他出口。蜘蛛到达终点页面后,只能选择爬向目标站点。为了确保蜘蛛能到达终点,池子会采用“多层跳转”策略:第一层页面链接到第二层,第二层链接到第三层,依此类推,直到最后一层。每一层都设置不同的关键词和内容主题,模拟自然站点的分类结构。蜘蛛在逐层爬行时,会认为自己在探索一个结构良好的网站,从而持续抓取。
四、动态调度与反识别策略
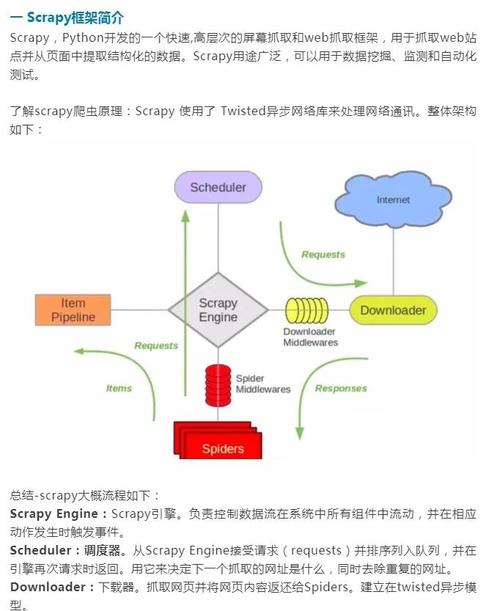
超级蜘蛛池并非静态系统。它需要实时监控蜘蛛的访问日志,分析蜘蛛的IP、User-Agent、访问频率和停留时间。一旦发现蜘蛛对某个IP或域名段产生“厌倦”(即抓取频次下降),系统会自动切换该域名解析到新的IP,或启用备用域名池。同时,系统会调整内容生成策略,增加新的关键词和文章模板,避免蜘蛛因内容重复而降低抓取意愿。
反识别策略还包括:模拟真实用户访问,在蜘蛛访问间隙插入少量正常用户请求,混淆服务器日志;使用CDN加速,隐藏真实服务器IP,防止被搜索引擎标记为“站群服务器”;对蜘蛛的请求返回200状态码,但对普通用户返回302跳转或空白页,从而避免人工审查发现池子内容。
五、效果边界与风险
蜘蛛池的效果取决于蜘蛛对池内页面的信任度。如果池内页面质量过低、链接过于集中,蜘蛛会将其判定为“链接农场”,并降低整个IP段的信任评级。因此,超级蜘蛛池需要不断更新域名、IP和内容,维持“新鲜感”。同时,搜索引擎的反作弊算法也在进化,例如通过机器学习识别动态生成的模板化页面,或通过图计算发现异常链接结构。一旦池子被识别,目标站点可能受到连带惩罚。
从技术角度看,超级蜘蛛池的运行原理是利用了蜘蛛抓取调度中的资源分配漏洞,通过规模化、动态化和伪装化,将有限的抓取配额集中引导至目标页面。它不创造权重,只转移权重;不提升内容质量,只提升内容被发现的概率。理解这一原理,有助于从防御角度设计更合理的网站架构,或从合规角度优化搜索引擎优化策略。
亮点功能
- ✦ 自己建蜘蛛池的方法:从零搭建高效爬虫池的完整实战指南
- ✦ 自己建蜘蛛池的方法:从零搭建高效爬虫池的完整实战指南
- ✦ 自己建蜘蛛池的方法:从零搭建高效爬虫池的完整实战指南