资源简介
搜索引擎蜘蛛是互联网内容发现与索引的基础执行单元。蜘蛛池并非某种单一软件,而是一套围绕蜘蛛行为特征构建的流量调度与内容分发系统。其核心目标在于:通过大量受控站点与链接结构,持续吸引搜索引擎蜘蛛访问,并将蜘蛛引导至目标页面,从而缩短目标页面的发现与收录周期。
要理解蜘蛛池的工作原理,必须先从蜘蛛的抓取决策机制入手。搜索引擎蜘蛛在爬行时,主要依赖三个输入:URL来源、历史抓取质量评分、以及站点更新频率。蜘蛛池正是对这三个输入进行系统性干预。
一、蜘蛛池的基础架构:入口层与承载层
蜘蛛池通常由两个逻辑层组成。入口层负责吸引蜘蛛,承载层负责容纳蜘蛛并输出链接。入口层由大量高权重、高更新频率的域名构成,这些域名可能来自过期域名抢注、站群互链或泛目录程序。承载层则是实际存放内容与链接的页面集合,通常采用动态生成或静态缓存方式,确保每次蜘蛛访问都能获得不同的URL与内容组合。
入口层与承载层之间通过站内链接、站群互链、以及外部引荐流量形成闭环。蜘蛛一旦进入入口层,便会沿着预设的链接路径进入承载层,进而触达目标URL。
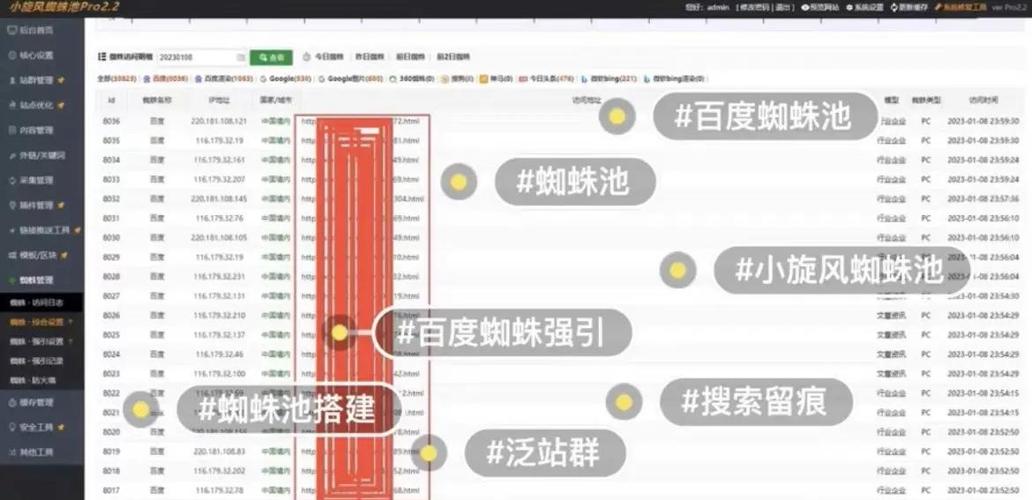
二、蜘蛛诱捕机制:如何让蜘蛛持续访问
蜘蛛池维持蜘蛛访问频率的关键在于制造“持续更新”的假象。具体手段包括:
第一,定时内容注入。系统按照固定时间间隔向承载层页面追加新段落、新标题或新链接,使页面最后修改时间不断变化。蜘蛛对频繁更新的页面会提高抓取优先级。
第二,URL动态生成。承载层页面在每次被请求时,可能生成不同的URL参数或路径变体,导致蜘蛛每次抓取都获得新URL。这些URL最终指向同一目标页面或同一内容集群,但蜘蛛会将其视为独立发现。
第三,链接深度控制。蜘蛛池会将目标链接放置在距离入口层较近的位置,通常不超过三次跳转。蜘蛛的抓取预算有限,浅层链接更容易被优先抓取。
第四,反向链接模拟。通过站群之间的互链,以及少量外部平台的外链,蜘蛛池为承载层页面制造持续的外部引荐信号,提升蜘蛛对站点重要性的判断。
三、蜘蛛调度与目标页面收录
蜘蛛池并不直接控制蜘蛛,而是通过链接结构引导蜘蛛的爬行路径。当蜘蛛进入承载层后,系统会通过以下方式将蜘蛛导向目标页面:
其一,在承载层页面的正文、侧栏或页脚嵌入目标URL。这些URL通常带有锚文本,锚文本与目标页面主题相关,以提高蜘蛛对目标页面主题的识别效率。
其二,使用跳转与规范化标签。部分蜘蛛池会在承载层放置302跳转或canonical标签,将蜘蛛直接指向目标页面,同时避免承载层页面与目标页面产生内容重复问题。
其三,控制抓取频率与并发。蜘蛛池会监控目标页面的访问日志,当蜘蛛访问频率下降时,自动增加承载层页面的更新频率或新增入口链接,重新激发蜘蛛兴趣。
四、秒收录的实现条件与边界
所谓秒收录,并非蜘蛛池单独作用的结果。它需要满足三个条件:目标页面本身具备可索引价值,服务器响应稳定且无robots封禁,以及蜘蛛池在短时间内向目标页面输送足够数量的高质量入口链接。当这三个条件同时成立时,蜘蛛可能在数分钟至数小时内完成抓取与索引。
但蜘蛛池的效果存在明显边界。搜索引擎的反作弊系统会识别异常链接增长、内容重复、以及URL模式突变。一旦被判定为操纵行为,蜘蛛池中的域名可能被降权,目标页面也可能被延迟索引或剔除。因此,蜘蛛池的工作原理本质上是一场与搜索引擎抓取策略和反作弊规则之间的持续博弈。
五、总结
蜘蛛池的工作原理可以概括为:通过入口层吸引蜘蛛,通过承载层维持蜘蛛访问频率,通过链接调度将蜘蛛导向目标页面,并利用蜘蛛对更新频率和链接权重的敏感性,压缩目标页面从发现到收录的时间窗口。其技术核心不在于“控制”蜘蛛,而在于“引导”蜘蛛的抓取预算与爬行路径。理解这一原理,有助于更理性地评估蜘蛛池的实际效果与风险。
亮点功能
- ✦ 蜘蛛池原理及用法揭秘:黑帽SEO如何操纵搜索引擎收录与排名
- ✦ 蜘蛛池原理及用法揭秘:黑帽SEO如何操纵搜索引擎收录与排名
- ✦ 蜘蛛池原理及用法揭秘:黑帽SEO如何操纵搜索引擎收录与排名