资源简介
PHP蜘蛛池搭建教程:从零构建高效新闻聚合平台的完整指南
蜘蛛池是一种通过集中管理大量域名与内容源,引导搜索引擎爬虫频繁抓取目标页面的技术架构。在新闻聚合场景中,合理运用PHP蜘蛛池可以显著提升内容收录效率与索引覆盖率。本文将系统讲解基于PHP的蜘蛛池搭建流程,涵盖环境准备、核心模块设计、爬虫调度、内容分发与日志监控。
一、环境准备与基础依赖
推荐使用Linux发行版(如Ubuntu 22.04或CentOS 7以上),搭配Nginx或Apache作为Web服务器。PHP版本需7.4或8.x,并开启curl、pdo_mysql、redis、mbstring、json扩展。数据库采用MySQL 5.7+或MariaDB 10.3+,缓存层使用Redis 6+。同时安装Composer用于依赖管理。
目录结构建议如下:
/spider_pool
├── config/
│   ├── database.php
│   └── redis.php
├── core/
│   ├── Spider.php
│   ├── Scheduler.php
│   └── ContentParser.php
├── public/
│   └── index.php
├── logs/
└── vendor/
二、核心数据表设计
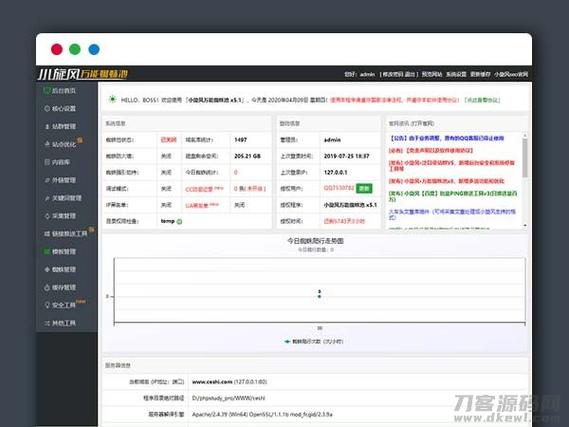
蜘蛛池需要管理域名池、内容源、抓取任务与访问日志。以下为关键表结构示例:
CREATE TABLE domain_pool (
    id INT AUTO_INCREMENT PRIMARY KEY,
    domain VARCHAR(255) NOT NULL UNIQUE,
    status TINYINT DEFAULT 1,
    weight INT DEFAULT 100,
    last_crawl DATETIME,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE content_source (
    id INT AUTO_INCREMENT PRIMARY KEY,
    source_url VARCHAR(500) NOT NULL,
    source_type VARCHAR(50) DEFAULT 'rss',
    category VARCHAR(100),
    update_interval INT DEFAULT 300,
    last_fetch DATETIME,
    active TINYINT DEFAULT 1
);

CREATE TABLE crawl_log (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    domain_id INT,
    source_id INT,
    spider_ip VARCHAR(45),
    user_agent TEXT,
    request_uri VARCHAR(500),
    response_code INT,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
三、蜘蛛调度器实现
调度器负责从域名池中按权重随机选取入口域名,并分配内容源抓取任务。以下PHP类展示了基于Redis的轮询与去重逻辑:
class Scheduler {
private $redis;
private $db;
public function __construct($redis, $db) {
$this->redis = $redis;
$this->db = $db;
}
public function pickDomain() {
$key = 'domain_pool:active';
$domains = $this->redis->sMembers($key);
if (empty($domains)) {
$this->loadDomainsToRedis();
$domains = $this->redis->sMembers($key);
}
$index = array_rand($domains);
return $domains[$index];
}
private function loadDomainsToRedis() {
$stmt = $this->db->query("SELECT domain FROM domain_pool WHERE status = 1");
while ($row = $stmt->fetch(PDO::FETCH_ASSOC)) {
$this->redis->sAdd('domain_pool:active', $row['domain']);
}
}
public function fetchSource($sourceId) {
$stmt = $this->db->prepare("SELECT source_url, source_type FROM content_source WHERE id = ? AND active = 1");
$stmt->execute([$sourceId]);
return $stmt->fetch(PDO::FETCH_ASSOC);
}
}
四、内容抓取与解析模块
抓取模块使用cURL多线程或Guzzle异步请求。解析模块需兼容RSS与HTML。以下示例展示RSS解析并提取标题、链接与发布时间:
class ContentParser {
public function parseRss($xmlContent) {
$items = [];
$xml = simplexml_load_string($xmlContent);
if ($xml === false) {
return $items;
}
foreach ($xml->channel->item as $item) {
$items[] = [
'title' => (string)$item->title,
'link' => (string)$item->link,
'pubDate' => (string)$item->pubDate,
'description' => (string)$item->description
];
}
return $items;
}
public function parseHtml($html, $selector) {
$dom = new DOMDocument();
@$dom->loadHTML($html);
$xpath = new DOMXPath($dom);
$nodes = $xpath->query($selector);
$results = [];
foreach ($nodes as $node) {
$results[] = trim($node->nodeValue);
}
return $results;
}
}
五、蜘蛛访问入口与内容分发
蜘蛛池的入口文件 public/index.php 需根据User-Agent识别搜索引擎爬虫,并返回动态生成的内容页。内容页应包含指向目标站点的链接,同时避免被识别为作弊。以下为简化入口逻辑:
$userAgent = $_SERVER['HTTP_USER_AGENT'] ?? '';
$spiderKeywords = ['Baiduspider', 'Googlebot', 'Sogou web spider', 'bingbot', 'YandexBot'];

$isSpider = false;
foreach ($spiderKeywords as $kw) {
    if (stripos($userAgent, $kw) !== false) {
    $isSpider = true;
    break;
    }
}

if ($isSpider) {
    $scheduler = new Scheduler($redis, $pdo);
    $domain = $scheduler->pickDomain();
    $source = $scheduler->fetchSource(rand(1, 100));
    $parser = new ContentParser();
    $items = $parser->parseRss(file_get_contents($source['source_url']));
    include __DIR__ . '/../templates/spider_page.php';
} else {
    header('HTTP/1.1 403 Forbidden');
    exit;
}
六、日志监控与反爬策略
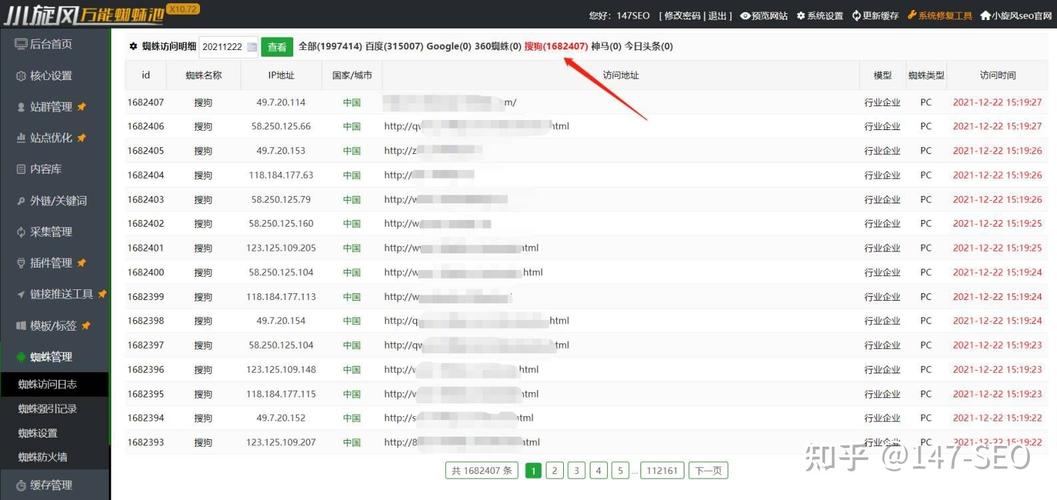
所有蜘蛛请求需记录到crawl_log表,便于分析抓取频率与来源IP。建议设置频率限制:同一IP每分钟不超过30次,同一域名每秒不超过5次。可使用Redis的INCR与EXPIRE实现滑动窗口。同时定期清理无效域名与失效内容源,保持池子健康度。
function checkRateLimit($redis, $ip, $limit = 30, $window = 60) {
    $key = 'rate:' . $ip;
    $current = $redis->incr($key);
    if ($current === 1) {
        $redis->expire($key, $window);
    }
    return $current <= $limit;
}
七、性能优化与部署建议
使用Supervisor守护PHP CLI进程,定时执行内容源更新与域名池刷新。Nginx配置中开启gzip与fastcgi缓存,减少重复解析开销。数据库添加索引:domain_pool(status)、content_source(active)、crawl_log(created_at)。Redis持久化采用AOF模式,避免调度数据丢失。
部署时建议将蜘蛛池与目标站点分离到不同服务器或容器,通过内网通信。若目标站点有CDN,需确保蜘蛛池返回的链接直接指向源站IP,避免CDN缓存干扰。定期审查robots.txt与sitemap,确保蜘蛛池行为符合搜索引擎规范。
以上为PHP蜘蛛池搭建教程的核心内容。实际运行中需根据抓取量动态调整并发数与域名权重,持续监控日志中的异常状态码,及时剔除失效源。通过模块化设计与缓存分层,可构建稳定高效的新闻聚合蜘蛛池系统。
亮点功能
- ✦ 滴滴蜘蛛池的相关介绍
- ✦ 滴滴蜘蛛池的相关介绍
- ✦ 滴滴蜘蛛池的相关介绍