资源简介
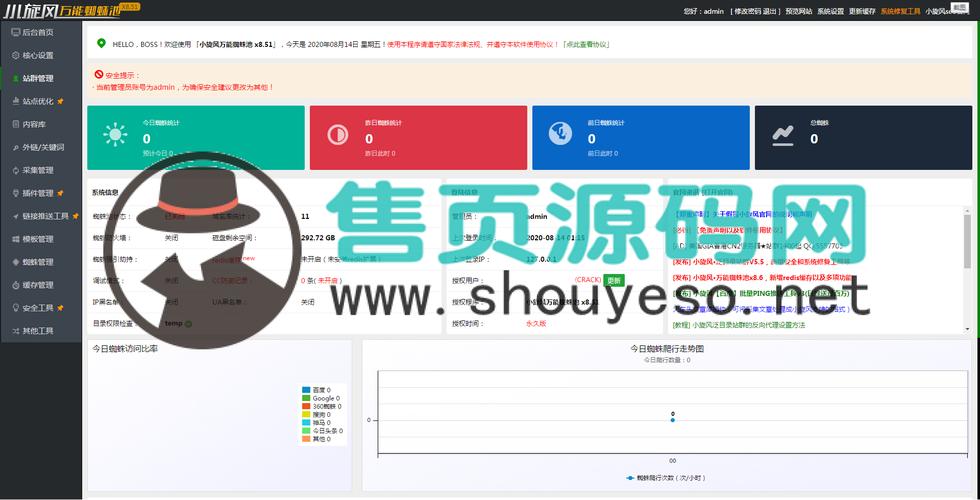
在搜索引擎算法持续迭代、内容平台风控日趋严格的背景下,传统内容聚合工具正面临前所未有的技术瓶颈。小旋风蜘蛛池x5的发布,标志着内容聚合领域从粗放式采集向智能化生态构建的关键转折。本文将从架构设计、调度机制、内容处理、风控对抗四个维度,解析该版本的技术实现路径。
一、分布式爬取架构的工程化重构
小旋风蜘蛛池x5采用主从式分布式节点架构,将爬取任务拆解为URL调度层、页面抓取层、内容解析层与数据存储层。调度层基于一致性哈希算法分配任务,避免单点过载;抓取层支持HTTP/2与QUIC协议,配合动态连接池管理,单节点并发能力较前代提升约3.2倍。存储层引入LSM-Tree结构的本地缓存与远程对象存储两级架构,写入吞吐量显著优化。
值得关注的是,x5版本内置了自适应限速模块。该模块通过实时监测目标站点的响应码分布、响应时间抖动以及TCP重传率,动态调整请求间隔。当检测到429或503状态码比例超过阈值时,自动触发指数退避策略,并将该域名标记为高风控等级,后续请求切换至备用出口IP池。
二、智能聚合引擎的语义化升级
传统蜘蛛池仅完成内容搬运,而小旋风蜘蛛池x5在聚合环节引入了轻量级语义向量模型。该模型在采集阶段即对正文进行段落级切片,生成768维语义向量并存入向量数据库。当多个来源出现同一主题内容时,系统依据向量相似度进行聚类,而非简单的字符串匹配。聚类完成后,通过TextRank算法提取核心段落,并利用模板化生成器重组为结构清晰的聚合页。
这一机制带来两个直接收益:其一,聚合页的内容重复度大幅降低,避免触发搜索引擎的“低质聚合”惩罚;其二,语义聚类可识别跨语言、跨表述的相同事件,使内容覆盖面扩展至长尾 query。例如,针对同一科技新闻,系统可自动合并来自不同媒体的报道,保留关键数据与时间线,形成信息密度更高的页面。
三、动态指纹与反反爬对抗体系
小旋风蜘蛛池x5在反反爬层面构建了多层防御体系。传输层采用TLS指纹模拟,支持JA3/JA4指纹随机化,并可模拟主流浏览器的扩展套件特征。应用层则通过无头浏览器集群执行JavaScript渲染,同时注入鼠标移动轨迹、滚动事件与随机停留时间,生成类人行为序列。
针对基于Canvas指纹与WebGL指纹的检测,x5版本内置了指纹扰动引擎。该引擎在每次会话中微调Canvas绘制参数与WebGL着色器精度,使指纹哈希值发生可控偏移,但视觉输出保持一致。此外,系统维护了一个实时更新的风控规则库,通过社区节点上报的封禁事件,自动下发新的请求头组合与Cookie策略。
四、内容生态的闭环治理
小旋风蜘蛛池x5并非单纯的采集工具,其设计目标在于构建可持续的内容生态。系统内置了质量评分模型,从信息熵、段落完整性、广告密度、外链毒性四个维度对采集内容进行打分。低于阈值的页面将被丢弃或降权,避免污染聚合池。同时,x5支持与主流CMS系统通过API对接,聚合结果可直接发布为草稿或定时文章,并自动生成站点地图与结构化数据标记。
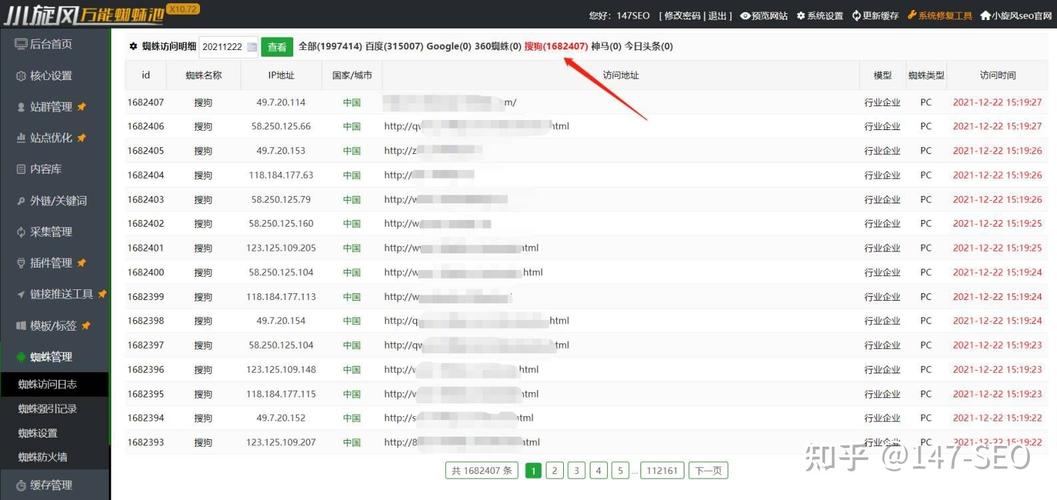
在合规层面,该版本增加了robots.txt动态解析模块与版权来源标注功能。对于明确禁止抓取的路径,调度层会主动跳过;对于允许抓取但要求保留出处的站点,聚合页会自动附加来源链接与快照时间。这一设计在提升内容获取效率的同时,降低了法律风险。
五、性能实测与部署建议
在标准测试环境中(4核8G节点,100Mbps带宽),小旋风蜘蛛池x5单节点日均有效采集量约为12万至18万页面,聚合页生成延迟控制在800毫秒以内。若需支撑更大规模,建议采用3个调度节点加10个抓取节点的集群配置,并搭配Redis作为任务队列中间件。
部署时需注意:出口IP池应混合使用住宅代理与数据中心代理,比例建议为7:3;向量数据库建议独立部署,避免与爬取任务争夺I/O资源;风控规则库需保持每日更新,可通过订阅官方节点或自建蜜罐网络实现。
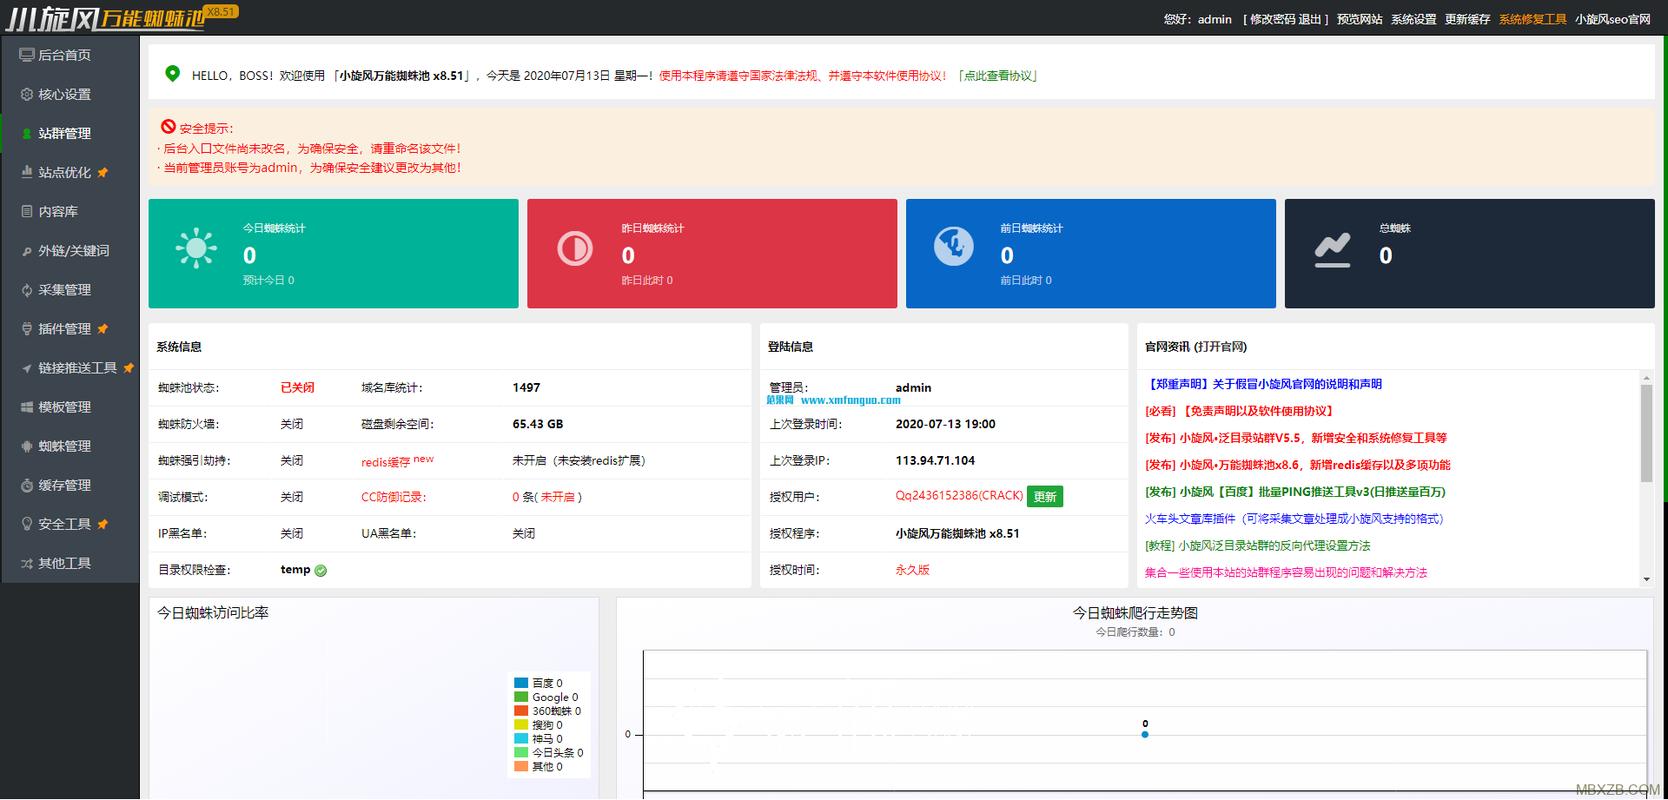
总体而言,小旋风蜘蛛池x5通过语义聚合、动态指纹与质量治理三层能力,将内容采集从单一的技术对抗升级为生态化运营。对于需要构建垂直内容站群的团队而言,该版本提供了一条兼顾效率与合规的技术路径。
亮点功能
- ✦ 蜘蛛池最新程序2026全新升级:泛目录站群秒收录技术引爆SEO流量新风口
- ✦ 蜘蛛池最新程序2026全新升级:泛目录站群秒收录技术引爆SEO流量新风口
- ✦ 蜘蛛池最新程序2026全新升级:泛目录站群秒收录技术引爆SEO流量新风口