资源简介
蜘蛛池站群源码是一套用于集中管理多个网站、引导搜索引擎蜘蛛爬取目标页面的技术系统。其核心目标并非简单的页面堆砌,而是通过分布式站点网络与调度逻辑,提升目标URL被搜索引擎发现和抓取的概率。本文从源码架构、核心模块、数据库设计、部署要点四个维度展开分析。
一、蜘蛛池站群源码的整体架构
典型的蜘蛛池站群源码采用分层架构,分为接入层、调度层、站点层与数据层。接入层负责接收外部请求或定时任务触发;调度层决定哪个站点响应、分配哪个目标URL;站点层由大量独立域名或子域构成,每个站点具备独立的模板与内容生成逻辑;数据层存储域名池、URL池、蜘蛛访问日志、抓取频次等。
源码中常见的设计模式为工厂模式与策略模式结合。工厂模式用于动态生成站点实例,策略模式用于切换不同的内容生成规则与蜘蛛识别逻辑。这种设计使得系统在增加站点时无需修改核心调度代码。
二、核心模块源码解析
1. 蜘蛛识别模块
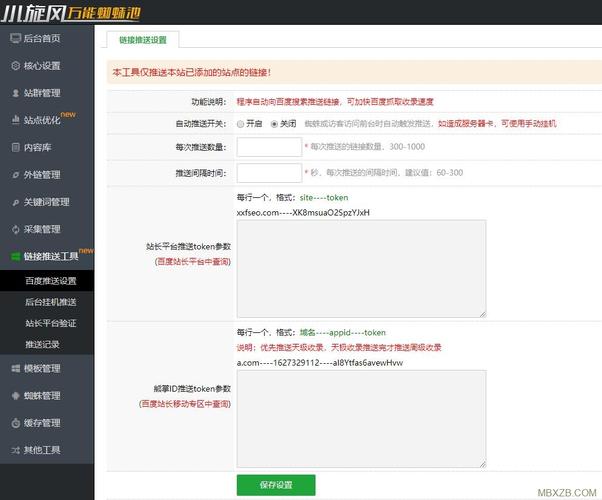
该模块通过User-Agent、IP反查、访问频率三个维度判断请求是否来自搜索引擎蜘蛛。源码中通常维护一个蜘蛛UA库与IP段库,并设置阈值:同一IP在60秒内请求超过20次且UA匹配,则标记为有效蜘蛛。伪代码如下:
function isSpider($ua, $ip) {
    $spiderAgents = ['Baiduspider', 'Googlebot', 'Sogou web spider'];
    foreach ($spiderAgents as $agent) {
        if (strpos($ua, $agent) !== false) {
            return checkIpSegment($ip) && checkFrequency($ip);
        }
    }
    return false;
}
2. 站点调度模块
调度模块决定将蜘蛛引导至哪个目标页面。源码中常用加权轮询算法,权重来源于站点的历史抓取成功率、域名年龄、内容更新频率。调度时从域名池中取出一个可用域名,拼接目标URL参数,返回302跳转或直接输出目标内容。关键点在于避免同一蜘蛛短时间内重复抓取同一站点,因此需要维护一个蜘蛛-站点映射表。
3. 内容生成模块
内容生成模块负责为每个站点生成差异化页面。源码中通常采用模板引擎加关键词替换的方式。模板中预留标题、正文、锚文本位置,运行时从词库中随机选取关键词填充。为避免内容完全重复,源码会引入同义词替换、段落顺序打乱、插入随机HTML注释等策略。部分高级源码还会调用本地缓存或伪原创接口。
三、数据库设计要点
蜘蛛池站群源码的数据库通常包含以下表:
- domain_pool:存储所有站点域名、状态、权重、最后抓取时间
- url_pool:存储待推广的目标URL、优先级、已抓取次数
- spider_log:记录每次蜘蛛访问的IP、UA、时间、访问站点、目标URL
- content_cache:缓存已生成的内容片段,减少重复计算
- schedule_map:记录蜘蛛与站点的映射关系,防止冲突
索引设计上,spider_log表按时间与IP建立复合索引,domain_pool表按权重与状态建立索引。查询调度时使用覆盖索引避免回表。
四、部署与运维实战
部署蜘蛛池站群源码时,需注意以下环节:
第一,域名解析。所有站点域名需泛解析至同一台服务器或负载均衡入口。源码中通过Host头区分不同站点。若使用CDN,需确保CDN不缓存动态调度结果。
第二,Web服务器配置。Nginx中需配置通配符server_name,并将所有请求转发至入口PHP或Python脚本。同时设置合理的限流规则,防止真实用户流量冲击蜘蛛池。
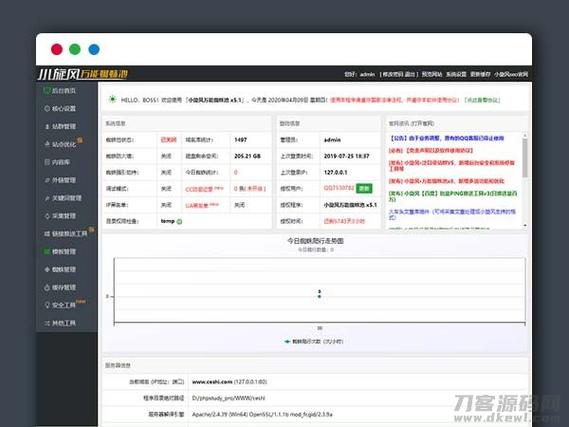
第三,日志与监控。源码应记录蜘蛛抓取成功率、平均响应时间、各站点被抓次数。建议接入Prometheus或自建统计面板,当某站点连续24小时无蜘蛛访问时触发告警。
第四,反屏蔽策略。搜索引擎会识别低质量站群,因此源码中需加入随机延迟、模拟正常用户访问、定期更换模板等逻辑。同时避免所有站点使用完全相同的HTML结构。
五、常见问题与优化方向
问题一:蜘蛛抓取量低。排查方向包括域名是否被惩罚、服务器响应是否超时、robots.txt是否误屏蔽。优化手段为增加高质量外链、提升内容独特性、降低单IP请求频率。
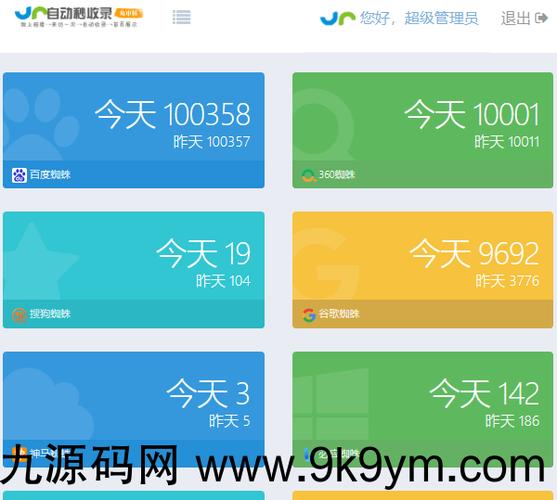
问题二:目标URL收录慢。可调整调度权重,将目标URL优先分配给权重高、抓取频繁的站点。同时检查目标URL是否被robots.txt禁止或存在跳转链过长。
问题三:源码性能瓶颈。当站点数量超过5000时,MySQL查询可能成为瓶颈。建议将域名池与URL池迁移至Redis,使用有序集合实现加权调度。蜘蛛日志可写入ClickHouse或Elasticsearch。
蜘蛛池站群源码的本质是一套流量调度与内容分发系统。理解其架构与核心算法后,可根据实际需求裁剪模块,例如仅保留蜘蛛识别与调度,去除内容生成,用于纯跳转场景。部署时务必关注合规性,避免对搜索引擎正常排序造成恶意干扰。
亮点功能
- ✦ 安徽360蜘蛛池租用助力企业高效收录,破解搜索引擎优化难题
- ✦ 安徽360蜘蛛池租用助力企业高效收录,破解搜索引擎优化难题
- ✦ 安徽360蜘蛛池租用助力企业高效收录,破解搜索引擎优化难题