资源简介
在搜索引擎优化领域,蜘蛛池采集关键字是一套被黑帽从业者长期使用、却极少被公开讨论的技术组合。它的核心逻辑并不复杂:通过批量域名与动态内容,诱导搜索引擎爬虫高频访问,再将爬虫引向目标站点,从而在短时间内制造出远超正常水平的收录与排名信号。本文从技术实现与风险控制两个维度,拆解这一流量操纵术的真实运作方式。
一、蜘蛛池采集关键字的基本架构
蜘蛛池本身是一个由大量低质量域名构成的站群系统,这些域名通常具备独立IP、独立解析记录,甚至分散在不同C段。采集关键字则是蜘蛛池的内容填充机制:系统从搜索引擎、新闻源、问答平台或竞品站点抓取文本,经过简单分词与重组后,生成大量带有目标关键字的页面。这些页面并不追求可读性,只追求两件事——被爬虫抓取,以及包含足够多的关键字变体。
典型的蜘蛛池采集关键字流程包含四个环节:
1. 关键字种子库构建:从行业词表、搜索下拉框、相关搜索以及竞品TDK中提取核心词与长尾词。
2. 采集源配置:针对每个关键字,定向抓取排名靠前的内容页面,保留标题、正文片段与URL结构。
3. 伪原创处理:通过同义词替换、段落打乱、插入无关短句等方式,绕过简单的重复内容检测。
4. 页面生成与推送:将处理后的内容批量发布到蜘蛛池域名下,并通过主动推送接口或外链引导爬虫发现。
二、采集关键字如何驱动爬虫行为
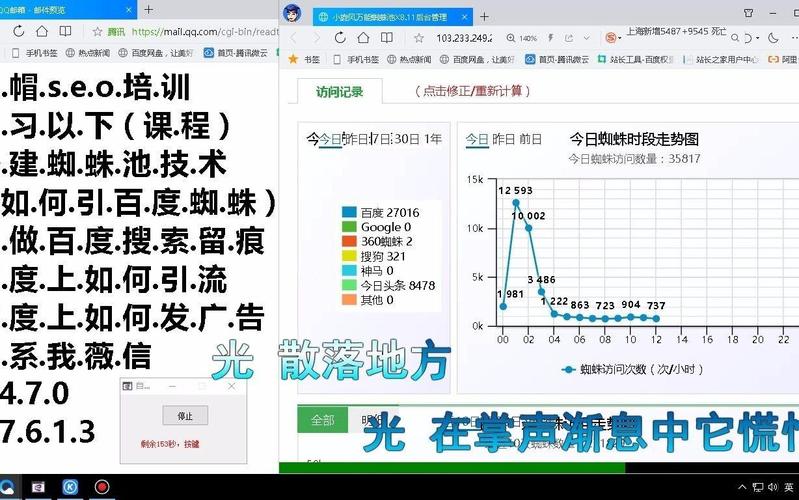
搜索引擎爬虫的调度策略遵循“高频更新、高链接权重、高抓取效率”优先原则。蜘蛛池采集关键字正是针对这三点进行设计。首先,池内页面每天大量新增或变更,触发爬虫的更新抓取队列。其次,页面之间通过站内链接形成密集的网状结构,使爬虫在单个域名内即可发现数千个URL。最后,采集内容中嵌入的目标关键字与目标站点URL,会在爬虫抓取时被记录为“关联信号”。
更隐蔽的做法是使用“爬虫陷阱”式跳转。当爬虫访问某个采集页面时,页面会通过JavaScript或302跳转,将爬虫引导至目标站点。由于跳转发生在爬虫层面而非用户层面,目标站点获得的抓取频次会显著上升,而真实用户几乎看不到跳转过程。这种手法在短期内可以大幅提升目标页面的收录速度,甚至影响部分长尾词的排名。
三、关键字采集中的技术细节
蜘蛛池采集关键字并非简单的复制粘贴。为了维持池子的“存活率”,操作者通常会在以下细节上做处理:
关键字密度控制:采集内容中目标关键字的出现频率一般控制在2%到5%之间,避免触发堆砌过滤。同时会混入同义词、近义词以及拼音变体,模拟自然语言分布。
URL结构模拟:池内页面的URL会模仿正规站点的目录层级,例如使用“/news/2024/关键字.html”或“/ask/关键字/”等格式,降低被识别为垃圾站群的概率。
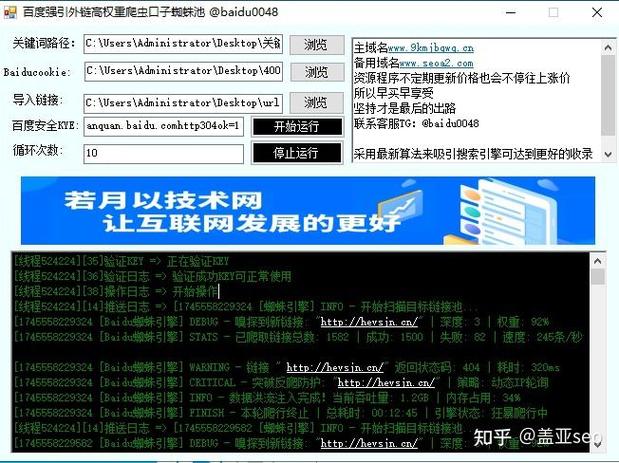
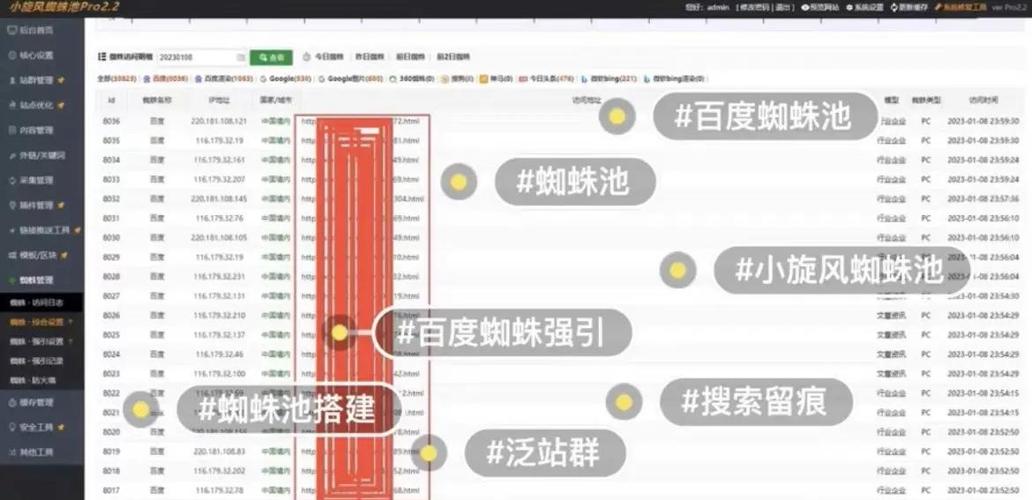
访问日志伪造:部分高级蜘蛛池会记录爬虫的User-Agent与访问时间,并据此调整内容更新频率。例如,当发现百度爬虫访问频繁时,系统会自动增加采集页面的更新量,形成正反馈循环。
反追踪机制:池内域名通常不会直接链接到目标站点,而是通过多层跳转、短链服务或JS注入完成最终导流。这样即使某个池域名被惩罚,目标站点也不会被直接关联。
四、风险与失效条件
蜘蛛池采集关键字的效果高度依赖搜索引擎的算法漏洞。一旦搜索引擎更新爬虫调度策略或加强垃圾内容识别,池子的抓取量会迅速下降。常见的失效条件包括:
1. 搜索引擎引入基于用户行为的质量评估,采集页面因无真实点击而被降权。
2. 主动推送接口增加内容指纹校验,伪原创内容无法通过。
3. 站群域名被批量识别,IP段或注册信息被标记为低质量来源。
4. 目标站点因突然获得大量异常外链或跳转,触发人工审核或算法惩罚。
从实际案例看,依赖蜘蛛池采集关键字获取排名的站点,通常在3到6个月内出现流量断崖。部分站点甚至被直接移除索引,恢复周期远超正常优化手段。
五、对正规SEO的启示
蜘蛛池采集关键字揭示了一个事实:搜索引擎的爬虫系统仍然存在可被操纵的路径。但对于正规从业者而言,理解这套技术的目的不是模仿,而是识别其痕迹。当竞品突然出现大量低质量外链、异常抓取频次或短时间内的排名跃升时,往往意味着其背后存在蜘蛛池操作。此时通过日志分析、外链画像与内容指纹比对,可以较为准确地判断风险来源。
更务实的做法是将资源投入到可持续的内容架构与用户体验优化中。搜索引擎对采集内容的识别能力正在快速提升,而真实用户行为数据、页面停留时间与转化路径,才是长期排名的稳定支撑。蜘蛛池采集关键字或许能带来一时的流量峰值,但它无法构建任何可积累的竞争壁垒。
亮点功能
- ✦ 蜘蛛池官网源码深度解析:从架构设计到SEO实战的完整技术指南
- ✦ 蜘蛛池官网源码深度解析:从架构设计到SEO实战的完整技术指南
- ✦ 蜘蛛池官网源码深度解析:从架构设计到SEO实战的完整技术指南