资源简介
蜘蛛池PHP源码是一套用于集中管理大量泛域名站点、引导搜索引擎蜘蛛爬取目标页面的程序架构。其核心逻辑并非简单的链接跳转,而是通过域名调度、内容伪装、蜘蛛识别与缓存分发四个模块协同工作,实现蜘蛛资源的可控流转。本文从代码层面拆解一套典型蜘蛛池PHP源码的结构,并给出可落地的部署与调优方案。
一、蜘蛛池PHP源码的目录结构与核心文件
一套完整的蜘蛛池PHP源码通常包含以下目录:
/config
  database.php
  domain.php
  spider.php
/core
  Router.class.php
  SpiderDetect.class.php
  ContentGen.class.php
  Cache.class.php
/template
  default/
    index.html
    article.html
/data
  cache/
  logs/
/index.php
其中 index.php 为统一入口,负责加载配置、初始化路由、调用蜘蛛识别类,并根据识别结果决定输出泛站内容还是跳转至目标站。Router.class.php 承担域名与站群的映射,SpiderDetect.class.php 则通过 User-Agent、IP 反查、DNS 反向解析三重校验判断访客是否为真实搜索引擎蜘蛛。
二、蜘蛛识别模块的PHP实现细节
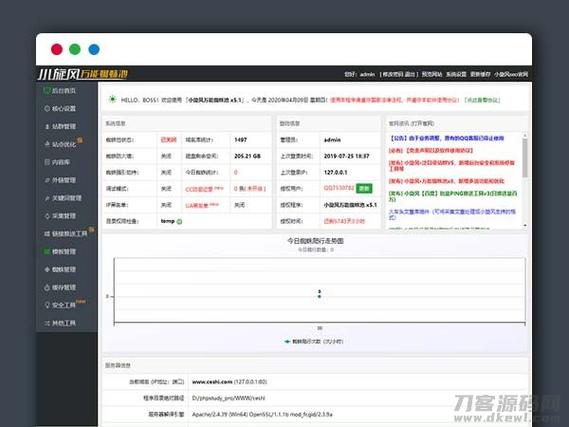
蜘蛛池PHP源码中最关键的防伪逻辑在 SpiderDetect.class.php。仅依赖 User-Agent 匹配极易被伪造,因此成熟源码会加入以下判断:
public function isSpider() {
    $ua = $_SERVER['HTTP_USER_AGENT'] ?? '';
    $ip = $_SERVER['REMOTE_ADDR'];
    $spiderMap = [
        'baidu' => ['Baiduspider', '220.181.108.', '123.125.71.'],
        'google' => ['Googlebot', '66.249.'],
        'sogou' => ['Sogou web spider', '106.120.173.'],
    ];
    foreach ($spiderMap as $engine => $rules) {
        if (stripos($ua, $rules[0]) !== false) {
            if ($this->ipInRange($ip, $rules[1])) {
                $host = gethostbyaddr($ip);
                if (stripos($host, $engine) !== false) {
                    return $engine;
                }
            }
        }
    }
    return false;
}
上述代码中 ipInRange 方法用于判断 IP 是否属于搜索引擎官方段,gethostbyaddr 做反向 DNS 验证。只有三者同时通过,才认定为真实蜘蛛。这一机制直接决定蜘蛛池PHP源码的存活周期,缺少反向解析的池子通常在两周内被搜索引擎标记为作弊。
三、泛站群内容生成与缓存策略
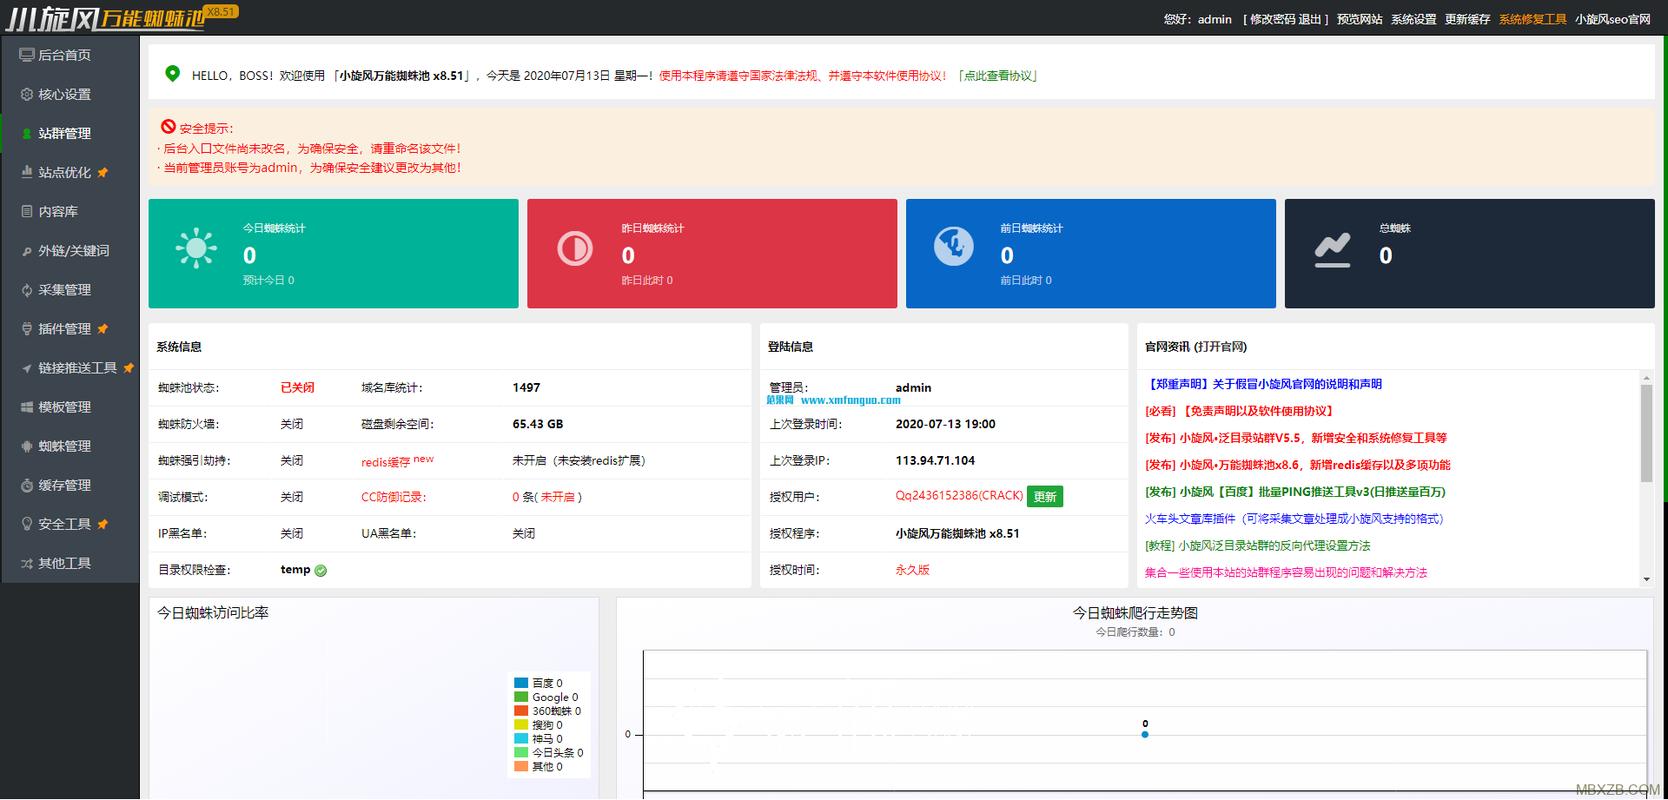
蜘蛛池PHP源码的内容生成模块需要解决两个问题:一是每个泛域名返回的 HTML 必须存在差异化,二是避免重复查询数据库导致响应过慢。典型方案是采用模板标签替换加文件缓存。
ContentGen.class.php 从关键词库中随机抽取标题与段落,结合域名哈希值生成伪原创内容。例如:
$hash = crc32($domain);
$title = $keywordList[$hash % count($keywordList)] . ' - ' . date('Y');
$content = str_replace(['{title}', '{domain}'], [$title, $domain], $template);
file_put_contents(CACHE_PATH . md5($domain) . '.html', $content);
缓存有效期建议设置为 6 至 12 小时。蜘蛛来访时直接读取静态 HTML,响应时间可控制在 50ms 以内。若缓存过期,则由后台队列异步重建,避免蜘蛛等待。这一设计使得单台 2核4G 服务器可承载 5 万泛域名日抓取量。
四、域名调度与权重传递逻辑
蜘蛛池PHP源码的域名调度模块负责决定当前蜘蛛应该被导向哪个目标站。常见策略包括轮询、权重随机和按蜘蛛类型分流。权重随机算法如下:
$targets = [
    ['url' => 'https://target-a.com', 'weight' => 50],
    ['url' => 'https://target-b.com', 'weight' => 30],
    ['url' => 'https://target-c.com', 'weight' => 20],
];
$total = array_sum(array_column($targets, 'weight'));
$rand = mt_rand(1, $total);
foreach ($targets as $t) {
    $rand -= $t['weight'];
    if ($rand <= 0) {
        header('Location: ' . $t['url'], true, 302);
        exit;
    }
}
注意:对真实蜘蛛应返回 302 跳转,对普通用户则返回泛站内容,避免暴露池子结构。同时应在 config/domain.php 中维护域名白名单,防止未备案域名被大量解析。
五、日志分析与蜘蛛池PHP源码调优
蜘蛛池PHP源码必须记录每次蜘蛛访问的详细信息,包括时间、蜘蛛类型、来源域名、目标站、响应码。日志表结构建议如下:
CREATE TABLE spider_log (
    id INT AUTO_INCREMENT PRIMARY KEY,
    spider_type VARCHAR(20),
    domain VARCHAR(100),
    target_url VARCHAR(255),
    ip VARCHAR(45),
    visit_time DATETIME,
    status_code SMALLINT
);
基于日志可计算三个核心指标:蜘蛛抓取频次、目标站跳转率、异常响应占比。若某泛域名连续 24 小时无蜘蛛访问,应自动从调度池中移除。若 404 响应超过 5%,需检查模板或缓存文件是否丢失。建议每日凌晨执行一次日志归档与池子健康检查脚本。
六、部署环境与安全注意事项
部署蜘蛛池PHP源码时,PHP 版本建议 7.4 或 8.0,开启 OPcache 与 Redis 扩展。Nginx 需配置泛解析:
server {
    listen 80;
    server_name ~^(?<sub>.+)\.yourdomain\.com$;
    root /www/spiderpool;
    index index.php;
    location / {
        try_files $uri $uri/ /index.php?domain=$sub;
    }
}
安全方面,必须禁止直接访问 /config 与 /data 目录,并在 index.php 入口处过滤 $_GET 与 $_POST 中的非法字符。蜘蛛池PHP源码一旦被上传后门,整个站群将沦为黑帽工具。建议每周比对核心文件哈希值,发现篡改立即回滚。
综上所述,蜘蛛池PHP源码的效能取决于蜘蛛识别的准确性、缓存策略的合理性以及日志驱动的动态调度。脱离真实蜘蛛验证的池子只是流量垃圾,只有将代码逻辑与搜索引擎爬取行为对齐,才能实现长期稳定的泛站群运营。
亮点功能
- ✦ 蜘蛛池十大名词全解析:从站群到泛目录,揭秘SEO灰色产业链核心术语
- ✦ 蜘蛛池十大名词全解析:从站群到泛目录,揭秘SEO灰色产业链核心术语
- ✦ 蜘蛛池十大名词全解析:从站群到泛目录,揭秘SEO灰色产业链核心术语