资源简介
蜘蛛池程序源码是一类用于集中管理大量站点、引导搜索引擎爬虫抓取目标页面的技术系统。其核心目标并非单纯制造流量,而是通过程序化方式调度站点资源、控制爬虫访问路径、分散抓取压力,并在合规前提下提升目标内容的收录效率。本文从源码结构、核心模块、数据库设计、部署要点与风险控制五个维度展开分析,面向具备一定后端开发与SEO工程经验的技术人员。
一、蜘蛛池程序源码的整体架构
典型的蜘蛛池程序源码采用分层架构,通常分为接入层、调度层、站点层与数据层。接入层负责接收爬虫请求,识别User-Agent、IP段与访问频率;调度层根据预设规则决定将爬虫导向哪个站点或页面;站点层由大量泛域名、子目录或独立域名组成,承载实际内容模板;数据层则记录爬虫日志、URL状态、跳转链路与收录反馈。
在源码实现上,多数程序使用PHP加MySQL作为基础组合,部分高并发场景会引入Redis作为队列与缓存,Nginx负责反向代理与泛解析。架构设计的关键在于解耦:爬虫识别、路由决策、内容渲染与日志回写应彼此独立,避免单点故障导致整个池子失效。
二、核心模块源码解析
1. 爬虫识别模块
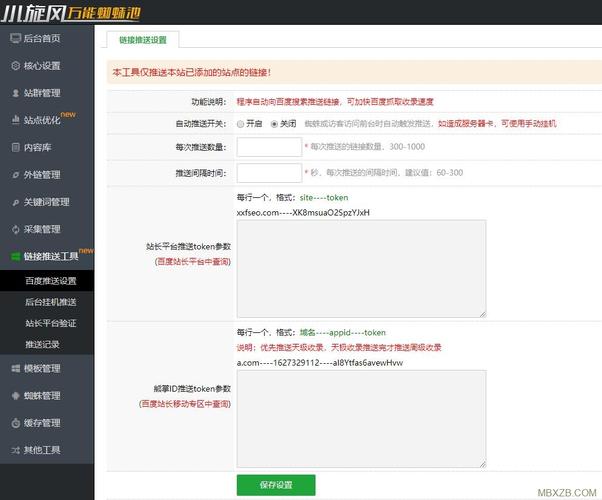
该模块通常位于入口文件,通过读取HTTP_USER_AGENT、REMOTE_ADDR与HTTP_REFERER进行判断。源码中常见做法是维护一个爬虫特征数组,包含百度、谷歌、必应、搜狗等主流爬虫的标识片段。为提高准确性,部分程序会结合反向DNS解析,验证IP是否属于搜索引擎官方网段。
function isSpider($ua, $ip) {
    $spiders = ['Baiduspider', 'Googlebot', 'bingbot', 'Sogou web spider'];
    foreach ($spiders as $s) {
        if (stripos($ua, $s) !== false) {
            return true;
        }
    }
    return checkReverseDns($ip);
}
需要注意的是,仅依赖User-Agent极易被伪造。生产环境中应加入IP白名单校验与访问频率阈值,避免普通用户或恶意采集器触发蜘蛛池逻辑。
2. 调度与路由模块
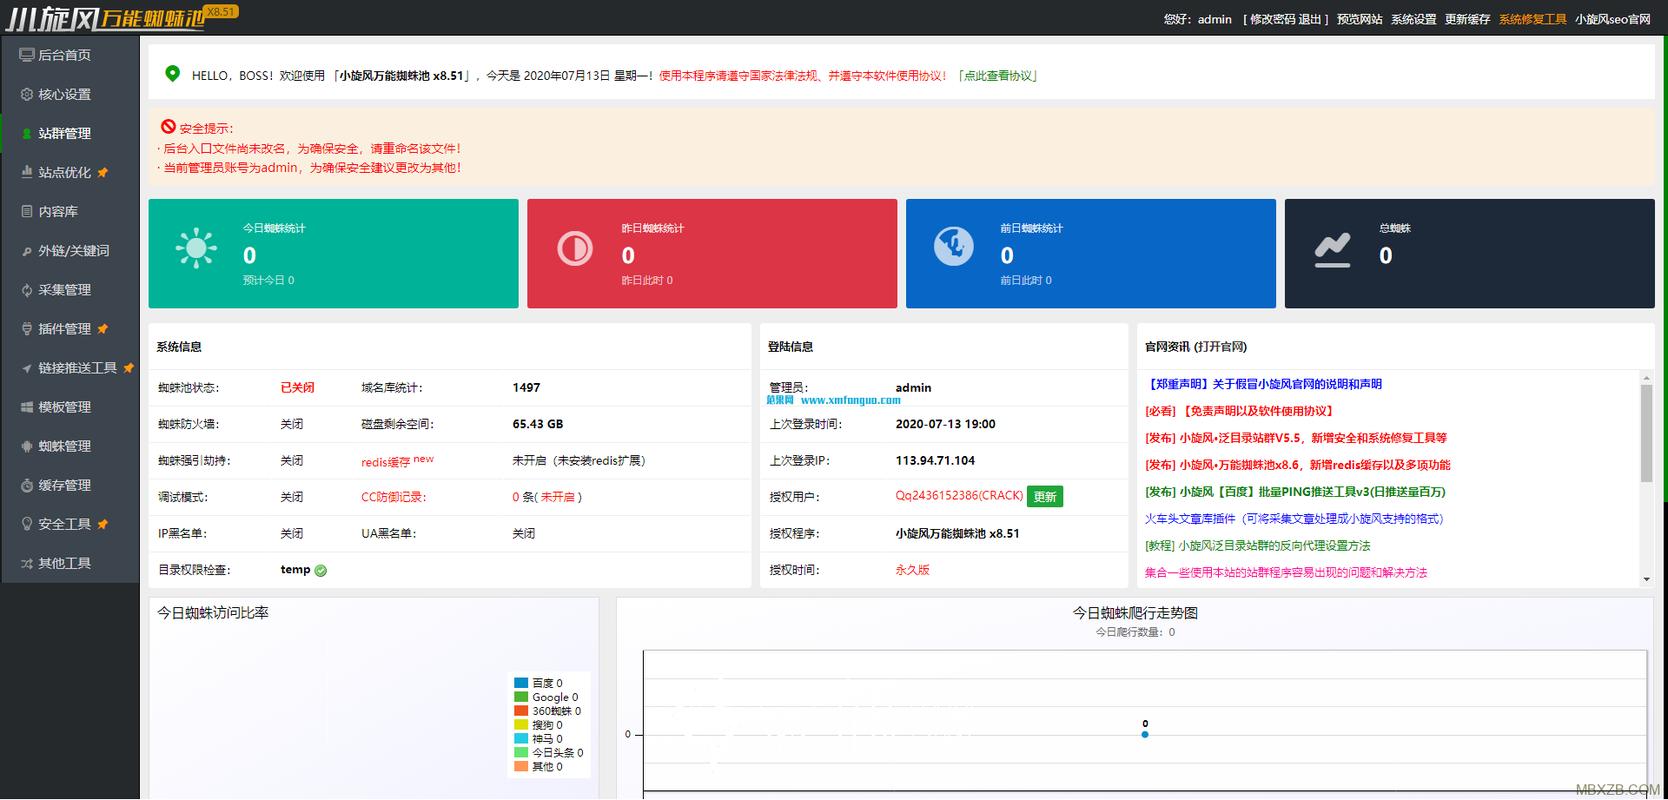
调度模块决定爬虫访问某个URL后跳转到哪里。源码中常见策略包括轮询、权重随机、基于域名权重的优先分配以及基于爬虫类型的差异化路由。例如,对百度爬虫分配收录较好的站点,对谷歌爬虫分配内容更完整的页面。
路由表通常存储在MySQL中,字段包括站点ID、域名、权重、状态、最后抓取时间。Redis用于缓存高频访问的路由决策结果,减少数据库查询压力。部分源码会实现A/B测试逻辑,对比不同跳转策略对收录率的影响。
3. 内容渲染模块
蜘蛛池站点内容多由模板加数据填充生成。源码中常见做法是预置多套HTML模板,结合关键词库、段落库与标题库进行伪原创组合。渲染层需控制页面加载速度,避免因大量动态查询导致爬虫超时。静态化生成是常见优化手段,将渲染结果写入HTML文件或对象存储。
从SEO角度看,内容模块应避免完全重复。源码中可引入同义词替换、段落顺序调整与内链随机插入,但需控制替换比例,防止语义混乱。
4. 日志与反馈模块
日志模块记录每次爬虫访问的IP、UA、访问URL、跳转目标、响应码与耗时。这些数据是后续优化的基础。源码中通常按天分表存储,并定期聚合统计各站点的抓取频次与收录变化。反馈模块则对接搜索引擎站长平台API,获取索引量、抓取异常与安全提示。
三、数据库设计要点
蜘蛛池程序源码的数据库设计直接影响扩展性。核心表包括:
- spider_log:记录爬虫访问明细,字段含id、ip、ua、url、target_url、status、created_at。
- site_list:站点主表,含域名、权重、分组、状态、最后抓取时间。
- route_rule:路由规则表,含爬虫类型、匹配条件、目标站点组、优先级。
- content_pool:内容素材表,含标题、段落、关键词、使用次数。
- index_status:收录状态表,含URL、搜索引擎、收录时间、最后检查时间。
索引设计上,spider_log的created_at与site_list的status应建立复合索引。对于大规模站点池,建议按站点ID进行分表或使用分区表,避免单表数据量过大导致查询缓慢。
四、部署与性能优化
部署蜘蛛池程序源码时,首先需要配置泛解析与通配符SSL证书,确保大量子域名可正常访问。Nginx配置中应开启gzip压缩、设置合理的keepalive超时,并对静态资源设置长缓存。PHP-FPM进程数需根据内存与并发量调整,避免爬虫突发流量导致502错误。
性能优化方面,Redis用于缓存路由决策与爬虫识别结果,减少MySQL压力。对于日志写入,可采用异步队列或批量插入,避免每次请求都直接写库。CDN可用于分散静态资源请求,但需注意爬虫IP可能被CDN节点掩盖,影响识别准确性。
监控体系应覆盖:爬虫访问量趋势、各站点响应时间、数据库慢查询、Redis命中率与服务器负载。一旦某站点被搜索引擎降权或封禁,系统应能自动将其从路由池中剔除。
五、合规风险与技术边界
蜘蛛池程序源码本身是中性技术,但其使用方式涉及明确的合规边界。搜索引擎的《robots.txt》协议与《互联网搜索引擎服务自律公约》对恶意跳转、桥页与作弊行为有明确限制。源码中若包含强制跳转、隐藏文本或Cloaking逻辑,极易导致站点被K站,甚至引发法律风险。
从技术角度看,合理的做法是将蜘蛛池用于多站点内容分发与抓取压力测试,而非欺骗搜索引擎。程序应保留完整的访问日志与跳转记录,便于审计。对于企业级应用,建议将蜘蛛池纳入SEO中台体系,与内容管理系统、站长平台API和数据分析平台打通,形成可监控、可回滚的技术闭环。
六、源码二次开发建议
拿到一份蜘蛛池程序源码后,不建议直接部署上线。应先进行代码审计,检查是否存在SQL注入、XSS、文件包含与命令执行漏洞。重点审查入口文件、路由分发与模板渲染部分。其次,根据自身业务规模调整数据库与缓存配置,小规模站点可先用单机MySQL,大规模站点应引入读写分离与分库分表。
功能扩展方面,可增加爬虫行为分析模块,识别异常抓取模式;增加自动收录检测模块,定时查询搜索引擎索引状态;增加站点健康度评分,综合响应时间、抓取频次与收录率动态调整权重。所有扩展应以数据驱动为前提,避免凭经验盲目调参。
蜘蛛池程序源码的价值在于其工程化能力,而非短期流量获取。理解其架构逻辑、掌握核心模块的实现方式、建立完善的监控与合规机制,才能在实际项目中发挥其技术作用。
亮点功能
- ✦ 蜘蛛池免费优化:低成本引爆搜索引擎流量的秘密武器
- ✦ 蜘蛛池免费优化:低成本引爆搜索引擎流量的秘密武器
- ✦ 蜘蛛池免费优化:低成本引爆搜索引擎流量的秘密武器