资源简介
蜘蛛池源码全向zjkwlgs在2026年的技术迭代中已经脱离了早期单纯依靠泛域名和站群互链的粗放模式。当前版本的核心逻辑围绕请求指纹伪装、分布式节点调度以及内容动态生成三个层面展开,其目标不再是欺骗搜索引擎爬虫,而是构建一个可被持续抓取且具备索引价值的内容分发网络。
从架构层面看,蜘蛛池源码全向zjkwlgs采用主控端与执行端分离的设计。主控端负责域名池管理、爬虫识别规则更新以及URL调度策略下发,执行端则部署在多个C段或不同ASN的服务器上,每个执行端独立运行轻量级Web服务与内容渲染引擎。这种分离使得单一节点被识别或封禁时,整体池子的抓取效率不会出现断崖式下跌。
请求指纹伪装是2026版源码中最关键的模块之一。传统蜘蛛池仅通过User-Agent判断来客身份,而现代搜索引擎爬虫会携带TLS指纹、HTTP2帧顺序、Header字段排列特征以及JavaScript执行能力检测。全向zjkwlgs在源码中引入了动态指纹库,针对百度蜘蛛、Googlebot、Bingbot以及字节跳动爬虫分别维护不同的握手参数与请求间隔模型。当执行端检测到请求特征与目标爬虫匹配时,才会触发完整的内容渲染与内链输出流程。
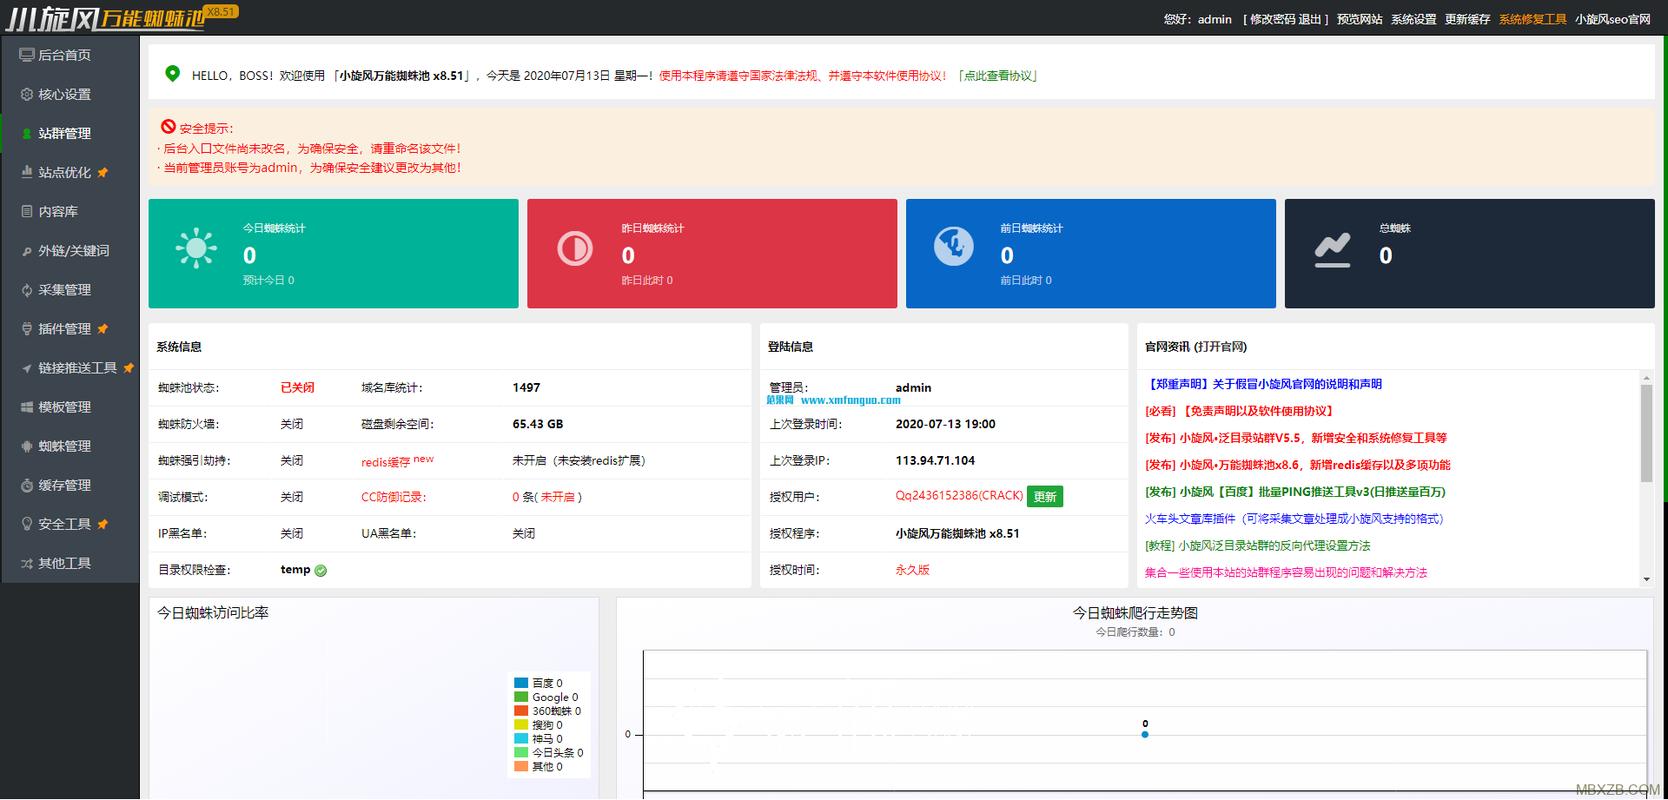
分布式节点调度方面,源码内置了基于一致性哈希的URL分配算法。每个执行端维护一个本地布隆过滤器,记录近期已抓取的URL指纹,避免同一爬虫在多个节点上重复获取相同页面。主控端通过心跳包收集各节点的负载、带宽与抓取成功率,动态调整域名解析权重。当某个节点连续返回5xx错误或响应时间超过阈值时,调度器会在30秒内将其从DNS轮询池中摘除。
内容动态生成模块摒弃了早期的随机段落拼接方案。全向zjkwlgs源码集成了轻量级模板引擎与语义向量库,执行端在收到爬虫请求后,会根据URL路径中的关键词从向量库中检索相关语料,再通过预训练的微型语言模型生成一段200至400字的连贯文本。该文本会自然嵌入目标页面的核心关键词与长尾变体,同时保持可读性,避免被搜索引擎的AI内容检测模型标记为低质采集。
在实战部署中,蜘蛛池源码全向zjkwlgs对服务器环境有明确要求。推荐使用Nginx作为前端反向代理,配合PHP 8.3或Go 1.22编写的执行端程序。数据库层面采用Redis存储URL队列与抓取状态,MySQL仅用于持久化域名池与爬虫日志。每个执行端建议配置独立的IPv6地址段,因为2026年主流搜索引擎已大幅提升对IPv6站点的抓取优先级。
域名池的构建策略同样影响最终效果。全向zjkwlgs源码支持泛解析与多级子域名混合模式,但需要注意每个顶级域名下的活跃子域名数量不宜超过500个。超过该阈值后,搜索引擎会降低该域名的整体抓取配额。源码中内置了域名健康度评分系统,根据历史抓取频率、索引留存率以及外链质量动态调整每个域名的权重。
内链网络的生成逻辑采用三层结构。第一层为入口页,通常使用高权重老域名承载,负责吸引爬虫首次访问。第二层为内容聚合页,部署在中等权重域名上,通过关键词锚文本指向第三层。第三层为长尾内容页,数量最多,分布在大量新注册或低成本域名上。全向zjkwlgs源码通过图数据库维护这三层之间的链接关系,确保每个长尾页面距离入口页的点击深度不超过4次。
日志分析与反制策略是持续运营的关键。源码内置了爬虫行为分析模块,能够识别伪造User-Agent的恶意抓取以及竞争对手的探测请求。当同一IP在短时间内请求超过设定阈值且不具备正常爬虫的请求间隔特征时,执行端会返回经过混淆的HTML内容或直接断开连接。所有日志通过Kafka管道汇总至主控端,用于每日更新指纹库与调度策略。
需要明确的是,蜘蛛池源码全向zjkwlgs本身是一套技术工具,其效果取决于部署者的内容质量与链接生态建设。单纯依靠源码而不投入内容维护与域名资源,无法在2026年的搜索环境中获得持续抓取。搜索引擎对链接作弊与内容农场的识别能力已大幅提升,任何试图绕过内容价值建设的技术手段都面临极高的失效风险。
从合规角度出发,使用蜘蛛池源码全向zjkwlgs时应严格遵守目标搜索引擎的robots协议与网站管理员指南。未经授权对第三方网站进行爬虫模拟或流量劫持属于违规行为。本文仅从技术架构与实现原理角度进行解析,不构成任何操作建议。实际部署前请评估当地法律法规与搜索引擎服务条款。
亮点功能
- ✦ 福建神马蜘蛛池租用市场持续升温,助力企业高效收录引关注
- ✦ 福建神马蜘蛛池租用市场持续升温,助力企业高效收录引关注
- ✦ 福建神马蜘蛛池租用市场持续升温,助力企业高效收录引关注