资源简介
蜘蛛池源码下载是SEO技术领域中一个长期存在但高度敏感的话题。本文从技术架构、运行机制与部署实践三个维度,对2024年流传的蜘蛛池系统源码进行剖析,不涉及任何具体下载链接或推广内容,仅作技术原理层面的讨论。
蜘蛛池的核心设计目标是通过大量域名与页面构建一个链接网络,引导搜索引擎爬虫(Spider)在短时间内访问目标站点。其源码通常包含以下模块:域名池管理、内容生成引擎、爬虫识别与调度、日志分析、反向链接注入。2024年公开流传的版本大多基于PHP加MySQL架构,部分采用Python Flask或Go语言重构,以提升并发处理能力。
一、蜘蛛池源码的典型目录结构
下载得到的源码压缩包解压后,常见目录如下:
/spider_pool
  /admin          后台管理入口
  /core           核心调度类
  /domains        域名池数据与配置文件
  /templates      页面模板(多为伪静态规则)
  /logs           爬虫访问日志
  /cron           定时任务脚本
  index.php       主入口
  config.php      数据库与全局参数
其中core目录下的SpiderScheduler类负责根据User-Agent识别爬虫类型,并分配不同的内容模板。域名池通常以TXT或JSON格式存储,每行一个域名,附带权重与状态标记。
二、爬虫识别与调度逻辑
源码中常见的爬虫识别方式有两种:一是匹配User-Agent中的关键词,如Baiduspider、Googlebot、Sogou web spider;二是反向DNS验证,通过gethostbyaddr确认IP是否属于搜索引擎官方网段。2024年版本中,部分源码增加了对HTTP/2指纹与TLS JA3指纹的校验,以过滤伪造爬虫。
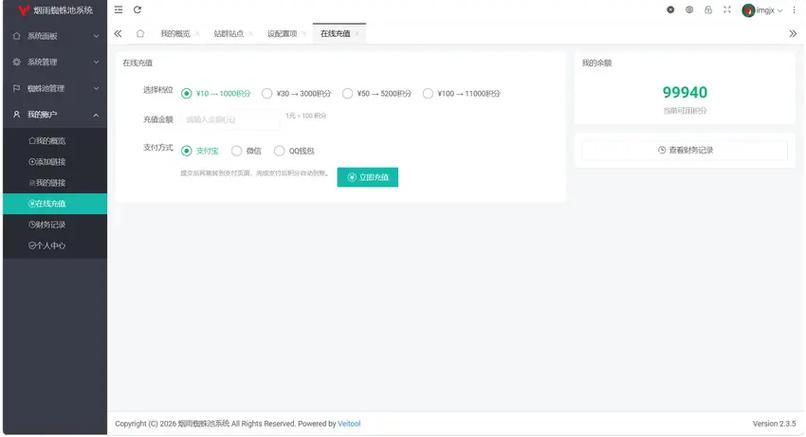
调度逻辑采用加权轮询算法。每个域名被赋予一个权重值,权重越高,被选为当前请求入口的概率越大。当爬虫访问入口页面后,源码会动态生成大量内链,指向同一池中的其他域名,形成闭合链路。此过程在日志中表现为短时间内大量不同域名的200状态码记录。
三、内容生成与反检测机制
为避免被搜索引擎判定为低质站点,2024年源码普遍引入以下机制:
1. 内容片段拼接:从预置的语料库中随机抽取段落,组合成看似通顺的文本,语料库通常按行业分类存储于data目录。
2. 模板随机化:同一套模板会动态替换CSS类名、JS变量名与HTML标签顺序,使每次渲染的DOM结构存在细微差异。
3. 访问频率限制:对同一IP的连续请求进行延迟响应,模拟正常用户浏览行为。
4. 死链与跳转:部分域名被标记为死链,访问后返回302跳转至目标站点,用于传递权重。
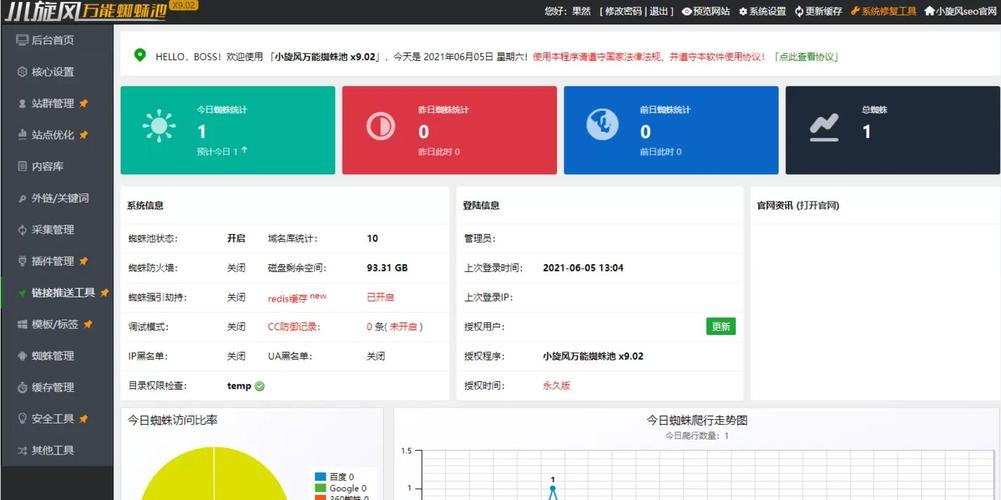
四、搭建教程的技术要点
若仅从技术学习角度搭建测试环境,需注意以下步骤:
第一步,准备一台具备独立IP的服务器,安装LNMP或LAMP环境。PHP版本建议7.4以上,MySQL建议5.7或8.0。
第二步,导入源码附带的SQL文件,修改config.php中的数据库连接信息与域名池路径。
第三步,配置伪静态规则。Nginx下需将所有非静态资源请求重写至index.php,Apache则使用.htaccess。
第四步,设置定时任务。cron目录下的脚本通常需要每5分钟执行一次,用于更新域名状态与清理过期日志。
第五步,绑定域名。将域名池中的域名解析至服务器IP,并在后台批量添加。
需要强调的是,蜘蛛池技术若用于操纵搜索结果,违反主流搜索引擎的站长指南,可能导致域名被永久封禁。本文仅从源码结构与运行原理角度进行客观描述,不鼓励任何违规操作。
五、2024年源码的变化与风险
与早期版本相比,2024年流传的蜘蛛池源码增加了对移动端爬虫的适配,并引入简易的API接口,允许外部程序提交目标URL。同时,部分源码捆绑了后门文件,例如在admin目录下隐藏的eval加密代码,可在服务器上执行任意命令。因此,任何源码在部署前都应进行静态代码审计,移除可疑的base64_decode与assert调用。
从法律层面看,未经授权入侵他人服务器或利用蜘蛛池进行流量劫持,可能触犯计算机信息系统安全相关法规。技术研究者应仅在本地隔离环境中分析源码逻辑,不得用于实际线上运营。
总结而言,蜘蛛池源码下载所获得的代码是一套围绕爬虫行为模拟与链接网络构建的自动化工具。其技术实现涉及HTTP协议、正则匹配、数据库调度与反检测策略。理解这些原理有助于SEO从业者识别异常流量模式,也能为搜索引擎反作弊研究提供参考样本。但任何脱离合规框架的使用,都将带来不可控的技术与法律风险。
亮点功能
- ✦ 河南头条蜘蛛池出租乱象调查:流量造假背后的灰色产业链
- ✦ 河南头条蜘蛛池出租乱象调查:流量造假背后的灰色产业链
- ✦ 河南头条蜘蛛池出租乱象调查:流量造假背后的灰色产业链