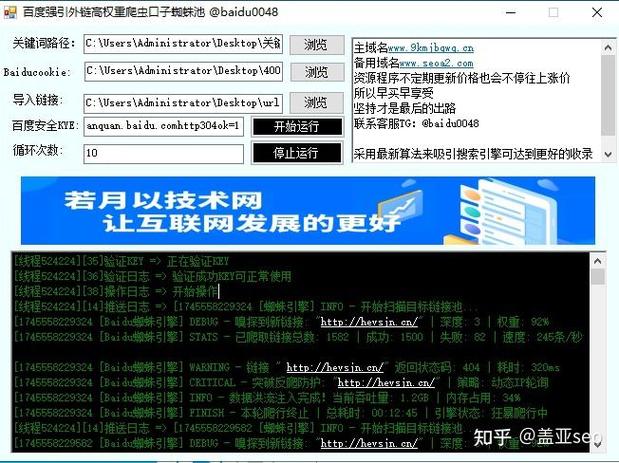
资源简介
在搜索引擎优化与数据采集领域,蜘蛛池是一个常被提及但少有系统讲解的技术架构。它并非黑帽手段的专属工具,而是一种通过集中调度爬虫资源、模拟自然访问行为、提升目标页面被搜索引擎蜘蛛抓取效率的工程方案。本文将从零开始,完整拆解手动搭建蜘蛛池的流程,涵盖环境准备、程序选型、域名与IP策略、日志监控与反屏蔽机制。全文不依赖任何现成商业面板,所有环节均基于可自主控制的代码与服务器资源。
一、蜘蛛池的核心逻辑与适用边界
蜘蛛池的本质是“用大量低权重入口引导蜘蛛爬向目标URL”。它不直接提升目标页面的排名,而是解决“新页面不被发现”或“深层页面抓取频率低”的问题。手动搭建意味着你需要自己管理域名解析、爬虫程序、代理IP池和请求调度器。与购买现成服务相比,手动方案的可控性更高,但要求搭建者具备基础的Linux运维、Python编程和HTTP协议知识。
适用场景包括:站群内容快速收录、多地域页面索引加速、API接口的爬虫压力测试。不适用于:试图操纵排名、制造垃圾外链、绕过搜索引擎的合理抓取限制。任何蜘蛛池都应遵守robots.txt协议与目标服务器的承载能力。
二、环境准备:服务器、域名与IP资源
2.1 服务器选型
建议使用至少两台VPS:一台作为调度中心(1核2G内存即可),另一台作为爬虫执行节点(2核4G起步)。操作系统推荐Ubuntu 22.04 LTS或Debian 11。调度中心负责分发URL队列、收集抓取结果、管理代理池;执行节点运行无头浏览器或HTTP客户端。若预算有限,可将两者合并,但并发能力会下降。
2.2 域名策略
手动搭建蜘蛛池不需要大量高权重域名,但需要一定数量的“入口域名”。这些域名的作用是生成指向目标URL的跳转或内容页。建议使用不同注册商、不同顶级域名的组合(如.com、.net、.org、.info),避免同一IP段下解析过多域名。每个入口域名应配置独立的A记录,指向调度中心或执行节点。域名数量建议从5到10个开始,后续根据抓取日志逐步增加。
2.3 IP资源与代理池
搜索引擎蜘蛛会记录访问来源IP。如果所有请求都来自同一IP,蜘蛛会降低抓取频率甚至封禁。手动搭建时,可使用数据中心代理或住宅代理。数据中心代理成本低但易被识别;住宅代理更接近真实用户但价格高。建议混合使用:调度中心使用固定IP,执行节点通过代理池轮换出口IP。代理池可自行搭建,使用开源的ProxyPool项目,或购买API接口。关键点:每个代理IP的请求频率应控制在每分钟3到5次以内。
三、爬虫程序选型与核心代码结构
3.1 为什么不用Scrapy默认配置
Scrapy是一个优秀的爬虫框架,但其默认的并发控制和去重机制不适合蜘蛛池。蜘蛛池需要模拟“蜘蛛”行为:随机延迟、随机User-Agent、跟随 robots.txt、优先抓取新链接。建议基于Python的requests + BeautifulSoup或httpx + parsel编写轻量级爬虫,或者使用Playwright处理JavaScript渲染页面。手动搭建时,推荐使用asyncio + aiohttp实现异步请求,以较低资源消耗获得较高并发。
3.2 核心模块划分
一个完整的蜘蛛池程序应包含以下模块:
- URL队列管理器:使用Redis的List或Sorted Set存储待抓取URL,支持优先级和去重。
- 代理调度器:从代理池获取可用IP,记录每个IP的成功率与封禁状态。
- 请求生成器:为每个URL随机生成Referer、User-Agent、Accept-Language等头部。
- 响应解析器:提取页面中的链接,判断是否为目标URL或入口域名下的新页面。
- 日志记录器:记录每次请求的时间、IP、状态码、响应大小,用于后续分析。
- 反屏蔽模块:处理验证码、JS挑战、频率限制。手动搭建时,建议使用延时重试和代理切换,而非破解验证码。
3.3 代码示例:异步请求与代理轮换
以下是一个简化的异步抓取函数,展示了如何从Redis队列取URL、从代理池获取代理、发送请求并记录日志。注意:实际部署时需增加异常处理和速率限制。
import asyncio
import aiohttp
import redis
import random
import time
r = redis.Redis(host='localhost', port=6379, db=0)
async def fetch(session, url, proxy):
headers = {
'User-Agent': random.choice([
'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15',
'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36'
]),
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9',
'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8'
}
try:
async with session.get(url, headers=headers, proxy=proxy, timeout=15) as resp:
text = await resp.text()
r.lpush('crawl_log', f'{time.time()}|{url}|{proxy}|{resp.status}')
return text
except Exception as e:
r.lpush('crawl_log', f'{time.time()}|{url}|{proxy}|ERROR|{str(e)}')
return None
async def worker():
async with aiohttp.ClientSession() as session:
while True:
url = r.rpop('url_queue')
if not url:
await asyncio.sleep(1)
continue
proxy = r.randomkey() # 简化示意,实际应从代理池获取
proxy_url = f'http://{proxy.decode()}'
await fetch(session, url.decode(), proxy_url)
await asyncio.sleep(random.uniform(1.5, 4.0))
# 启动多个worker
# asyncio.run(asyncio.gather(*[worker() for _ in range(5)]))
四、域名与URL的调度策略
4.1 入口域名与目标URL的映射
蜘蛛池中的每个入口域名应生成一个独立的“入口页面”,该页面包含指向目标URL的链接。入口页面本身可以是简单的HTML,内容与目标页面主题相关。例如,目标页面是关于“手动搭建蜘蛛池”的教程,入口页面可以是一段摘要加一个“阅读全文”的链接。搜索引擎蜘蛛抓取入口页面后,会顺着链接进入目标页面。
映射关系应存储在数据库中,推荐使用SQLite或MySQL。每条记录包含:入口域名、入口路径、目标URL、创建时间、最后抓取时间。调度器根据最后抓取时间决定是否重新生成入口页面或更换链接。
4.2 抓取频率控制
蜘蛛池最忌“洪水式”请求。手动搭建时,应设置全局速率限制:每秒总请求数不超过10,每个入口域名每秒不超过1次。使用Redis的令牌桶或漏桶算法实现。同时,根据目标服务器的响应时间动态调整:若响应时间超过2秒,自动降低该域名的请求频率。
4.3 链接深度与广度
蜘蛛池不应只指向一个目标URL。建议每个入口页面包含3到5个目标链接,且这些链接指向同一站点的不同页面。这样蜘蛛会认为入口页面是一个“导航页”,从而增加抓取深度。同时,入口页面之间可以互相链接,形成一个小型站群,但注意不要形成闭环导致蜘蛛陷入无限循环。
五、日志监控与反屏蔽机制
5.1 关键日志指标
手动搭建蜘蛛池必须监控以下指标:
- 每个代理IP的请求成功率与平均响应时间。
- 每个入口域名的蜘蛛访问次数(通过User-Agent识别Baiduspider、Googlebot、Bingbot等)。
- 目标URL的抓取频率与最后抓取时间。
- HTTP 429、403、503状态码的比例。
- 队列长度与处理速度。
建议使用Grafana + Prometheus或简单的Python脚本将日志写入InfluxDB,并设置告警:当某个代理IP连续失败5次,自动从池中移除;当某个入口域名24小时内无蜘蛛访问,自动更换内容或增加外链引导。
5.2 反屏蔽策略
搜索引擎蜘蛛不会主动屏蔽你,但目标服务器可能部署了WAF或频率限制。手动搭建时,可采取以下措施:
- 使用住宅代理,避免数据中心IP被标记。
- 随机化请求间隔,避免固定周期。
- 模拟真实浏览器行为:加载CSS、JS、图片(但会消耗带宽,可选择性加载)。
- 对于返回JS挑战的页面,使用Playwright或Selenium执行JS后再提取链接。
- 设置合理的Retry-After,遇到429时等待指定时间再重试。
- 不要使用同一个User-Agent连续请求同一域名。
5.3 蜘蛛识别与优先级
在日志中识别蜘蛛的User-Agent,并给予更高优先级。例如,当Baiduspider访问某个入口页面时,调度器应立即将该页面中的目标链接加入高优先级队列,并在5分钟内安排一次抓取。这可以形成“蜘蛛来了就引导”的正反馈。但注意不要伪造User-Agent,否则可能违反服务条款。
六、部署与运维要点
6.1 使用Docker Compose编排
手动搭建不意味着手动敲每一条命令。建议使用Docker Compose定义服务:redis、scheduler、worker、proxy_pool、monitor。每个worker可水平扩展。示例docker-compose.yml片段:
version: '3.8'
services:
  redis:
    image: redis:7-alpine
    ports:
      - "6379:6379"
  scheduler:
    build: ./scheduler
    depends_on:
      - redis
    environment:
      - REDIS_HOST=redis
  worker:
    build: ./worker
    depends_on:
      - redis
    deploy:
      replicas: 3
  proxy_pool:
    build: ./proxy_pool
    ports:
      - "5010:5010"
6.2 安全与合规
蜘蛛池的请求应遵守目标网站的robots.txt。如果目标网站禁止抓取,应停止对该站点的请求。同时,不要将蜘蛛池用于DDoS攻击或爬取敏感数据。手动搭建的蜘蛛池应设置白名单,仅允许抓取你拥有或获得授权的域名。
6.3 定期维护
每周检查一次代理池的可用性,删除失效代理。每月审查一次入口域名的蜘蛛访问日志,淘汰无蜘蛛访问的域名。每季度更新一次User-Agent列表,以匹配主流浏览器版本。同时,监控服务器资源:CPU、内存、网络带宽。若带宽持续超过80%,应增加执行节点或降低并发。
七、常见问题与排查
问题1:蜘蛛完全不访问入口页面。 检查入口域名是否被搜索引擎索引。新域名需要先提交站点地图,或通过外链引导。手动搭建时,可先手动访问入口页面,确认返回200状态码且无robots.txt屏蔽。
问题2:蜘蛛访问频繁但目标URL未被索引。 检查入口页面中的链接是否可被爬虫解析。避免使用JavaScript跳转或nofollow属性。确保目标URL返回200且内容与入口页面主题相关。
问题3:代理IP大量被封。 降低请求频率,增加代理池规模,混合使用住宅代理。检查是否在短时间内对同一域名发送了过多请求。建议每个代理IP每天对同一域名的请求不超过50次。
问题4:日志显示大量429状态码。 目标服务器在限流。立即降低该域名的请求频率,并增加Retry-After等待。如果持续出现,考虑更换目标URL或暂停对该域名的抓取。
八、总结
手动搭建蜘蛛池是一项需要耐心和细致调优的工程。它不依赖任何黑盒工具,所有环节均可审计、可调整。核心在于:合理的域名与IP资源、异步爬虫程序、严格的频率控制、实时的日志监控。遵循本文的步骤,你可以从零构建一个稳定运行的蜘蛛池,用于加速合法内容的收录。记住,蜘蛛池只是工具,内容质量与网站结构才是搜索引擎优化的根本。
亮点功能
- ✦ 超级蜘蛛池积分体系全面升级,赋能站长高效引流新生态
- ✦ 超级蜘蛛池积分体系全面升级,赋能站长高效引流新生态
- ✦ 超级蜘蛛池积分体系全面升级,赋能站长高效引流新生态